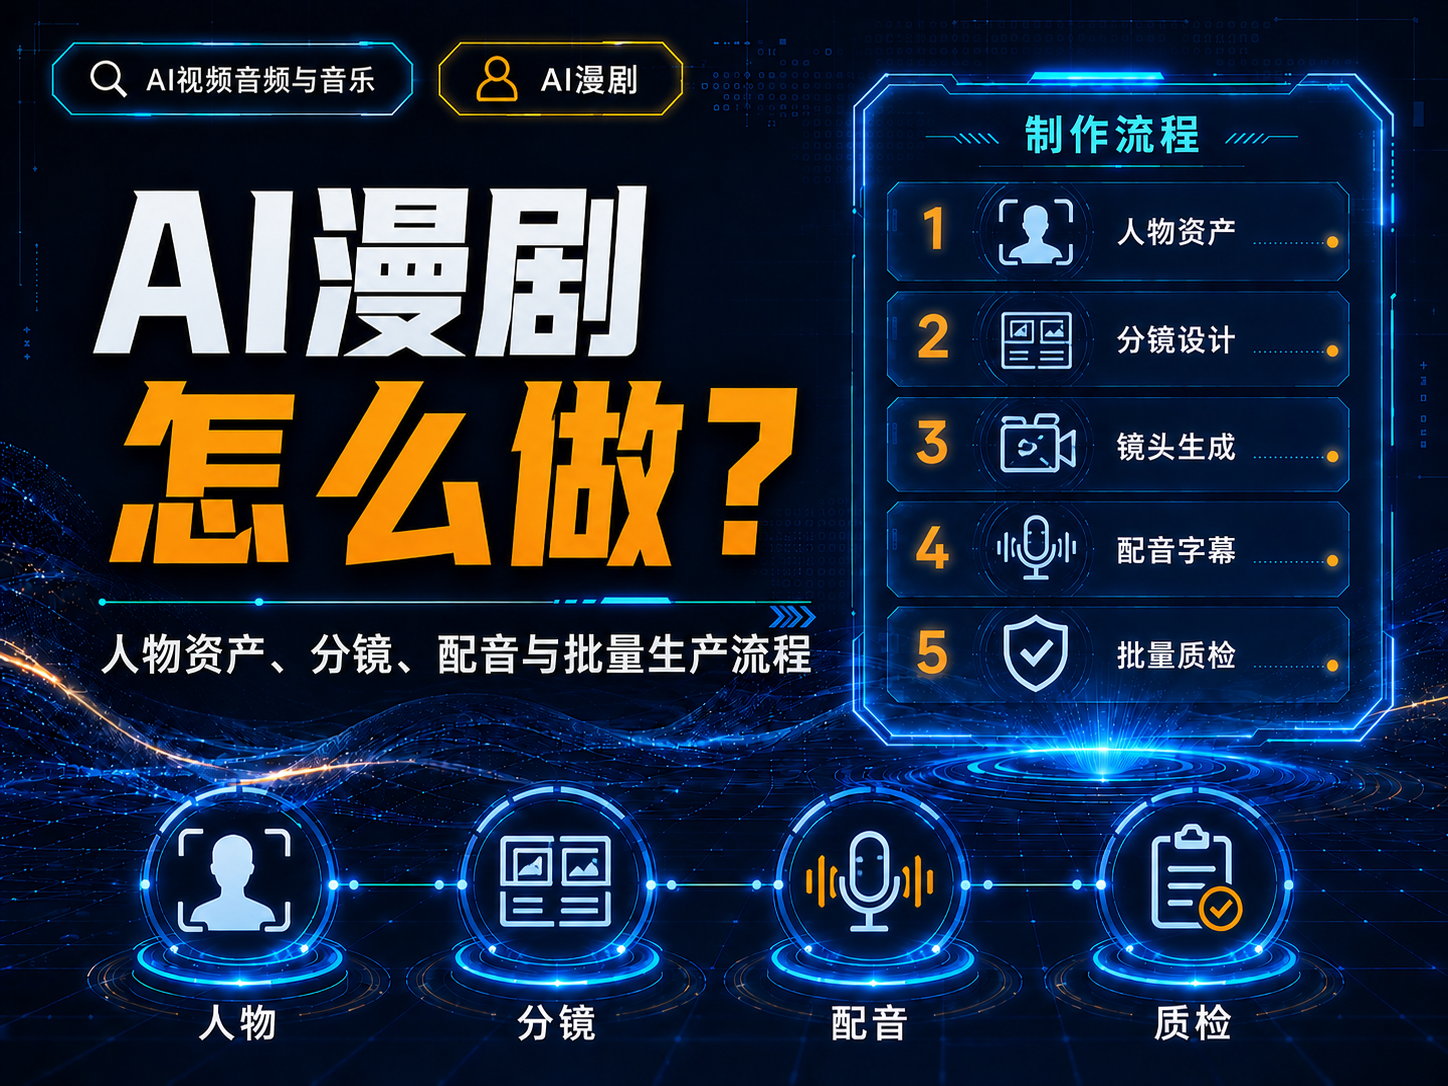
第一阶段:建立可重复使用的资产库
- 角色:主视图、侧视图、全身图、服装阶段、表情与年龄说明。
- 场景:室内外布局、主光方向、色调、关键家具与入口出口。
- 道具:主角常用物品、车辆、武器/工具、文件等。
- 声音:角色声线、语速、口头习惯、专有名词词典。
第二阶段:把剧本拆成可生成镜头
每个镜头只承担一个明确动作或叙事目的。对话场景可拆成建立镜头、A说话、B反应、关键细节、收尾镜头。这样比“一段完整对白一次生成”更容易控制人物和节奏。
第三阶段:图像参考与视频生成
参考图用于锁定角色和风格;视频提示词主要描述动作、机位和镜头运动。复杂连续动作建议拆成多个短镜头,通过剪辑和声音维持连续性。
第四阶段:配音、音效、字幕
ElevenLabs TTS可用于长短旁白与角色语音,Sound Effects可根据文本描述生成环境声和转场声。声音层最好单独导出,便于更换台词或重新剪辑。
批量生产为什么要有“人工闸门”
- 生成后先做角色一致性和穿帮检查。
- 对白必须与镜头时长匹配。
- 字幕需核对名字、数字和专有名词。
- 每集保存版本号、提示词、参考图和最终成片。
- 只有通过角色、剧情、声音、字幕四项检查才能进入发布队列。
资料核验日期:2026-08-09。模型、套餐、功能、地区和平台条款会变化,正式使用前请再次查看官方页面。
参考来源
- Runway:Creating with Gen-4 Image References(official,核验于 2026-08-09)
- Runway:Creating with Gen-4.5(official,核验于 2026-08-09)
- ElevenLabs:Text to Speech documentation(official,核验于 2026-08-09)
- ElevenLabs:Sound effects documentation(official,核验于 2026-08-09)
更新记录
- 2026-08-09:完成官方/一手来源核验、结构化撰写与发布边界检查。
如果你还想系统比较Suno、Udio、Lyria、Eleven Music、MiniMax、Stable Audio等AI音乐平台,可以继续查看:AI音乐生成专题 →
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章



 百度热点