直接回答:AI图片工具没有一个脱离场景的“总冠军”。应把需求拆成写实、插画、设计/文字、编辑与商业使用,再用同一提示词、尺寸、参考图和重复次数测试。当前工具和模型迭代很快,发布排名前必须保存原图与测试日期。[1][2]
需实测:本文只给选型框架和官方能力边界,不给未完成统一测试的画质排名。
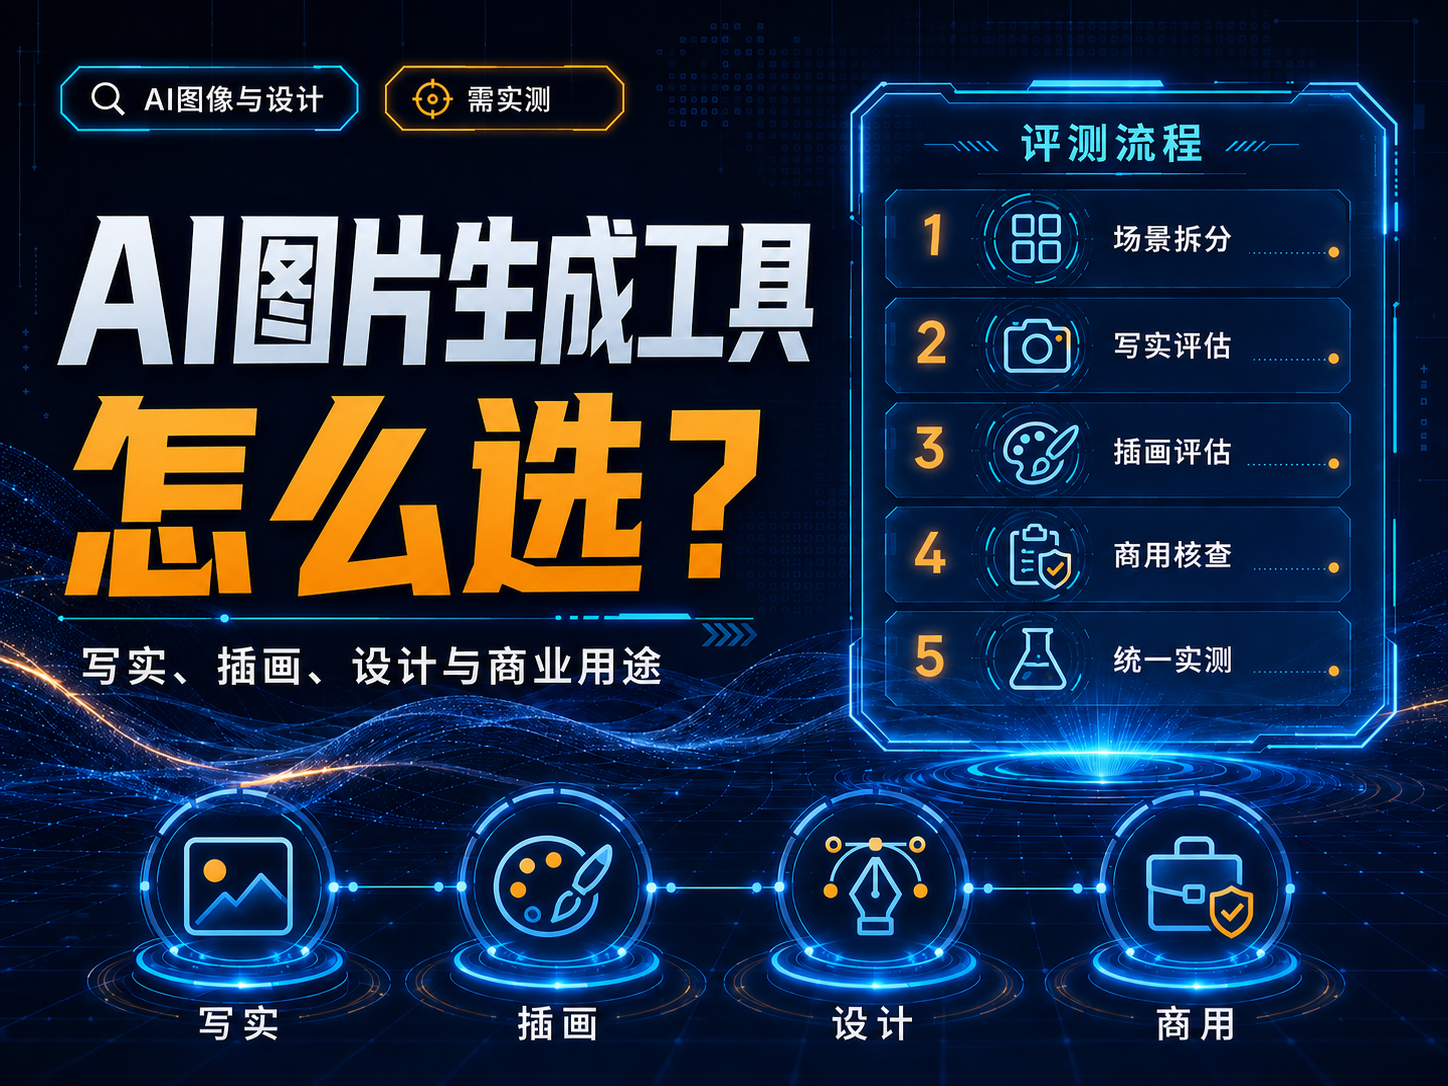
先按任务选,不要问“谁画得最好”
写实人像、插画、品牌设计、产品图、带字海报和商业素材对模型的要求不同。当前主流平台也在快速迭代:OpenAI当前API推荐GPT Image 2;Google Gemini图像模型强调高分辨率和文字渲染;Adobe Firefly提供生成与编辑工作流;Midjourney则有自己的版本、图像提示和风格体系。[1][2][3][4]
| 场景 | 测试重点 | 统一样本 |
|---|---|---|
| 写实 | 人物结构、材质、自然光、细节 | 同一人像/产品描述 |
| 插画 | 风格稳定、构图、角色一致 | 同一故事角色 |
| 设计 | 文字、布局、品牌色、可编辑性 | 同一4:3海报 |
| 商业用途 | 许可、隐私、训练/上传条款 | 同一真实业务需求 |
商业用途先看条款,再看画质
Adobe Firefly FAQ说明非beta功能生成的输出可用于商业项目,但不同平台条款、计划和地区会变化;使用前仍应核对当前许可、品牌/人物权利和上传素材授权。[3]
统一实测至少做四轮
- 同一纯文本提示词。
- 同一参考图(平台支持时)。
- 同一尺寸/比例与尽可能接近的质量档。
- 每个任务重复多次,记录最好图和平均失败类型。
不要只挑最好的一张比
出图工具具有随机性。应记录一次成功率、结构错误、文字错误、重复生成次数和后期修图时间。对于商业团队,“平均能否稳定交付”比偶尔出神图更重要。
测试原图要保存
比较文章应保存原始提示词、参考图、参数、模型/版本、日期和全部原图,否则日后无法复核,也不适合发布“最好”排名。
参考来源
- OpenAI API:GPT Image 2(核验于 2026-08-08)
- Google AI:Gemini image generation(核验于 2026-08-08)
- Adobe Firefly FAQ(核验于 2026-08-08)
- Midjourney Docs:Version(核验于 2026-08-08)
更新记录
- 2026-08-08:核验官方资料并完成全文结构化撰写。
如果你想系统比较当前主流AI图像模型和工具,可以继续查看:AI图像生成专题 →
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章



 百度热点