
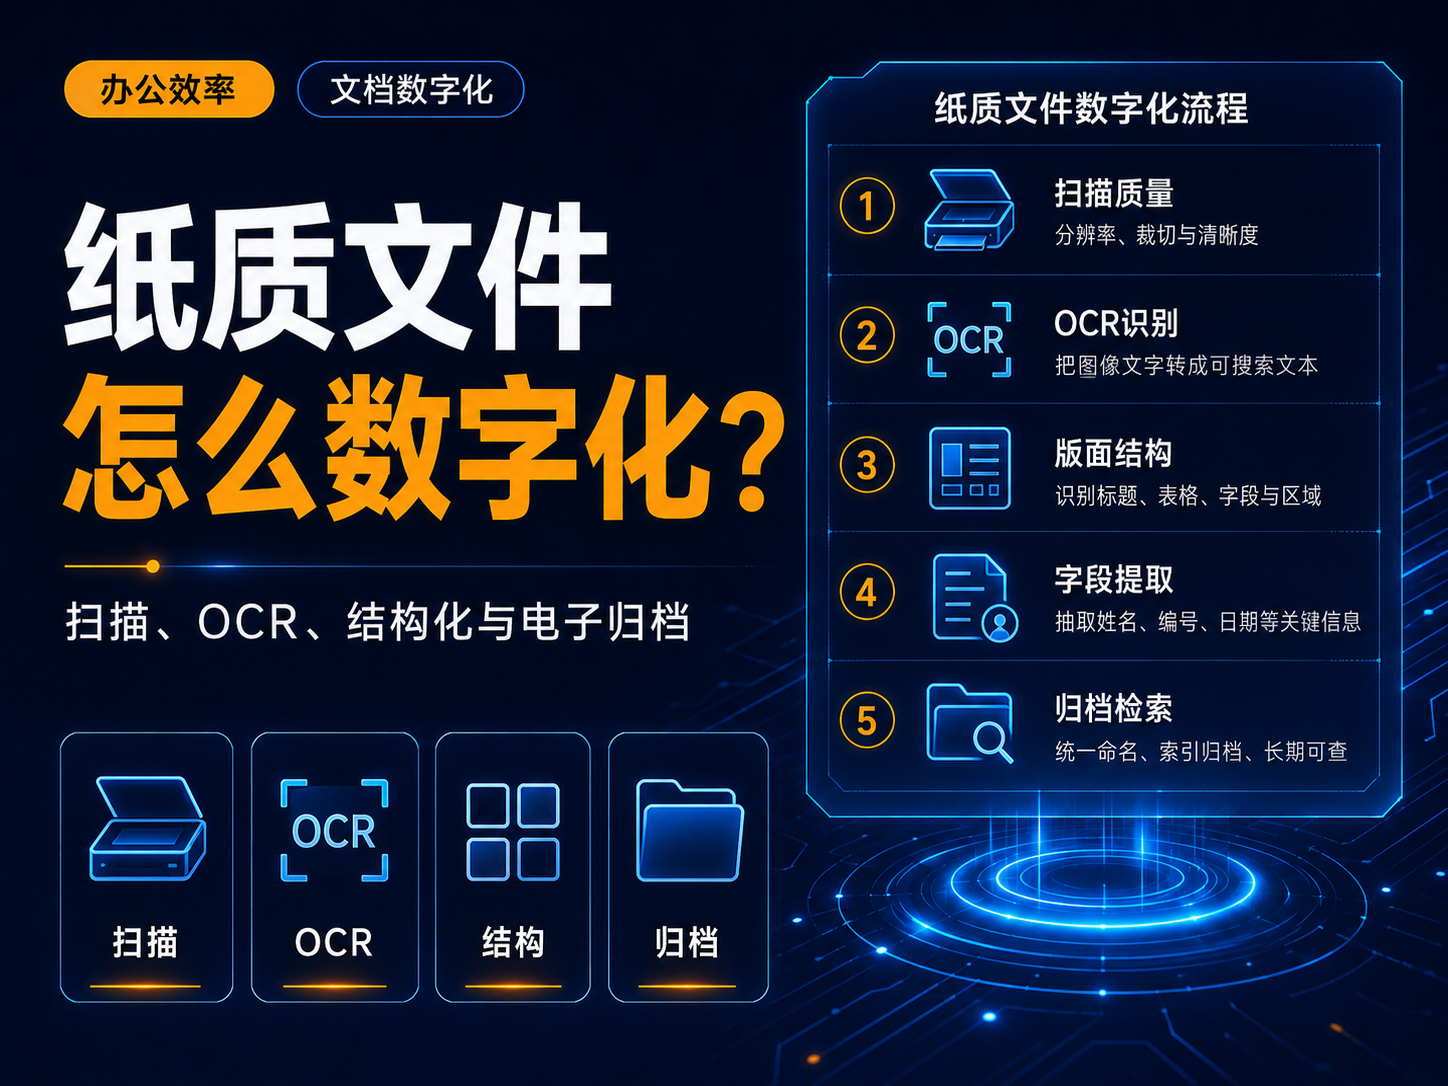
直接回答:纸质文件数字化的完整流程应是“扫描或拍摄 → 图像质量检查 → OCR → 版面/表格/字段结构化 → 人工抽检 → 统一命名与元数据 → 权限、备份和归档”。只把照片存进网盘,不算真正数字化;真正有价值的是让文件可搜索、可引用、可批量处理,并且能回到原始扫描件核对。Azure Document Intelligence与Google Document AI都把OCR与文档结构、表格和字段提取作为文档处理的重要组成部分。[1][2]
资料核验日期:2026-08-08。本文讨论通用工作流,不代表特定OCR产品准确率排名。
第一步:先决定“为什么要数字化”
不同目标决定后面的处理深度。只是备份凭证,只需要清晰扫描和可靠存储;如果要全文检索,需要OCR;如果要自动入账、建档或统计,还需要结构化字段;如果涉及合同、档案或合规材料,还要保留原始件、页序和审计记录。
| 目标 | 最低处理要求 | 建议额外保留 |
|---|---|---|
| 电子备份 | 清晰扫描、页序正确 | 原件位置、扫描日期 |
| 全文检索 | OCR文本层 | 文档类型、日期、关键词 |
| 字段录入 | 结构化提取 | 字段置信度、人工复核状态 |
| 长期档案 | 原图+可检索版本 | 版本、权限、保留期限、校验记录 |
第二步:扫描质量比模型更重要
OCR再强,也无法稳定修复严重模糊、透视变形、反光、缺角和低对比度。批量处理前先做小样:统一纸张方向、裁边、去阴影、检查页码,并避免手机自动滤镜把淡色印章或手写批注抹掉。对于有法律或财务价值的文件,建议保留未经增强的原始扫描件。
第三步:OCR只负责“读字”,结构化负责“读文档”
普通OCR把像素转换成文本;文档智能服务会进一步识别段落、表格、键值对、选择标记和版面结构。Azure官方说明Document Intelligence结合OCR与文档理解提取文本、表格、结构和键值对;Google Document AI也面向端到端文档处理。[1][2]
第四步:设计统一的数据结构
先定义字段,再批量跑模型。发票可能需要发票号、日期、金额和税额;合同需要名称、主体、签署日期、到期日;档案需要编号、类别、责任人和保留期限。结构化字段必须有“原文位置”和“是否人工确认”两个辅助字段,这样出现错误时能追溯。
第五步:建立质量抽检
- 随机抽检至少覆盖清晰件、模糊件、手写件、复杂表格和多页文件;
- 数字、日期、身份证号、金额等高风险字段单独校验;
- 不要只计算字符准确率,还要检查页序、表格关系和字段归属;
- 低置信度和规则冲突自动进入人工队列。
第六步:文件名、目录和元数据要统一
文件名建议包含“日期-类型-主体-编号”,但不要把所有信息塞进文件名。真正可扩展的系统应把分类、标签、保留期和权限放入元数据。这样以后换文件系统或知识库时,不会因为目录层级过深而失控。
第七步:归档不是“上传完就结束”
长期归档要解决四件事:谁能看、保存多久、如何备份、怎样证明版本没有被替换。对重要文件,保留原扫描件、OCR结果和结构化数据三层;内容更新时不要覆盖原始版本,而应生成新版本并记录时间。
推荐最小工作流
- 先选20份有代表性的纸质文件做试点;
- 扫描并人工检查图像质量;
- 跑OCR和结构化提取;
- 建立字段规则和低置信度阈值;
- 人工复核关键字段;
- 统一命名、分类和权限;
- 确认备份与恢复后再批量处理。
常见问题
手机拍照能代替扫描仪吗?
轻量资料可以,但批量档案、细小文字、双面纸和需要长期保存的材料更适合稳定扫描设备。无论用什么设备,都应先检查清晰度和页序。
OCR结果能直接删除原图吗?
不建议。OCR是派生数据,原扫描件才是核验依据。重要文件应同时保存原始图像和可检索文本。
文章局限
- 不同语言、字体、纸张和扫描质量会显著影响OCR效果。
- 涉及档案、财务和法律保留要求时,应按所在地区和组织制度执行。
参考来源
- Microsoft Azure Document Intelligence 概览(核验于 2026-08-08)
- Google Cloud Document AI 概览(核验于 2026-08-08)
更新记录
- 2026-08-08:首次整理并核验官方或一手资料,形成可复用流程。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章



 百度热点