直接回答:用AI重构旧代码时,最重要的是行为保持。先把现有行为写成可执行测试或验收样例,再让AI按小步修改;每一步都必须比较diff、跑回归、检查接口与数据兼容,并保留能快速回滚的提交。
需实测:原始选题要求受控测试。本文提供重构框架,不宣称某个AI工具在重构任务中成功率最高。
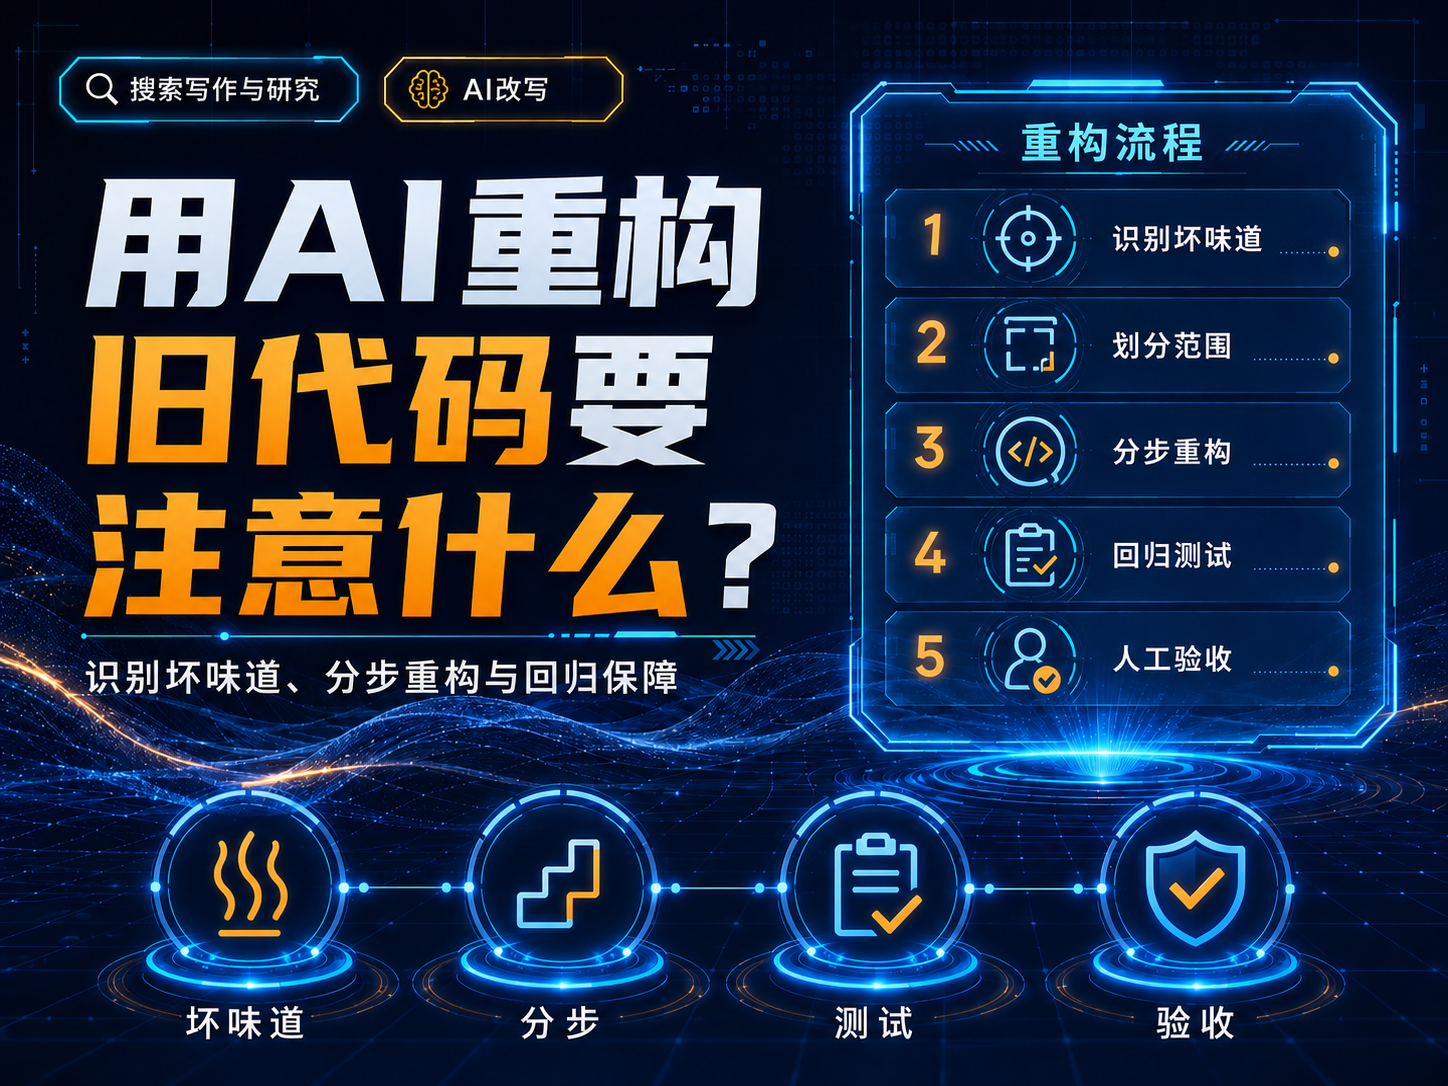
第一步:先冻结“现在到底怎么工作”
旧代码最大的难点是很多行为没有文档,甚至“不合理行为”也可能已经被调用方依赖。先用现有测试、真实请求样本、数据库结果和日志建立行为基线。
第二步:补保护性测试
pytest把fixture定义为可重复、可靠的测试上下文;参数化则适合把多组边界输入统一跑过同一行为。[1][2] 重构前最值钱的不是100%覆盖率,而是覆盖你不能破坏的路径。
第三步:把重构拆成小步
| 步骤 | 适合AI做什么 | 验收 |
|---|---|---|
| 纯命名/抽函数 | 机械性改动 | 行为完全不变 |
| 分层 | 提取服务/适配器 | 接口和副作用一致 |
| 替换依赖 | 写adapter、迁移调用 | 旧/新双跑 |
| 数据迁移 | 迁移脚本、校验脚本 | 可回滚、数据核对 |
第四步:限制AI修改范围
明确“允许改哪些文件、禁止改哪些接口、不得新增依赖、不得改变数据库schema”等约束。Cursor Agent、Codex和Claude Code都有执行多文件修改和命令的能力,权限越大,边界越要明确。[3][4][5]
第五步:每一小步都做三次检查
- 自动:单元、集成、类型、lint;
- 结构:diff是否包含无关改动;
- 业务:关键输入输出、性能和数据副作用是否一致。
什么时候要“双轨迁移”
核心支付、权限、结算、数据同步等模块不要一次切换。可以保留旧实现作为fallback,或让新旧路径在影子流量下同时计算并比较结果,再逐步放量。
用故障注入测试AI重构
如果要评估不同AI工具,准备同一份旧代码和相同保护性测试,给同样的重构目标。统计测试通过、无关diff、API兼容、人工修正次数和完成时间,而不是主观看“代码更漂亮”。
最容易踩的坑
- 让AI一次重构整个目录;
- 边改功能边重构;
- 先删旧测试再重写新测试;
- 只看编译成功;
- 没有数据库和外部接口回归;
- 没有回滚点。
参考来源
- pytest Docs:Fixtures(核验于 2026-08-08)
- pytest Docs:Parametrization(核验于 2026-08-08)
- Cursor Docs:Agent Modes(核验于 2026-08-08)
- OpenAI:Codex(核验于 2026-08-08)
- Anthropic:Claude Code CLI(核验于 2026-08-08)
更新记录
- 2026-08-08:整理AI旧代码重构的保护性测试与分步迁移框架;受控实测待补。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


 百度热点