直接回答:AI理解陌生代码库最稳的方法是先地图、后路径、再细节:先让它列目录和技术栈,再找启动入口和依赖边界,然后沿一条真实请求或数据流向下追踪,最后用测试、配置和Git历史验证理解。不要一上来要求“总结整个仓库”。
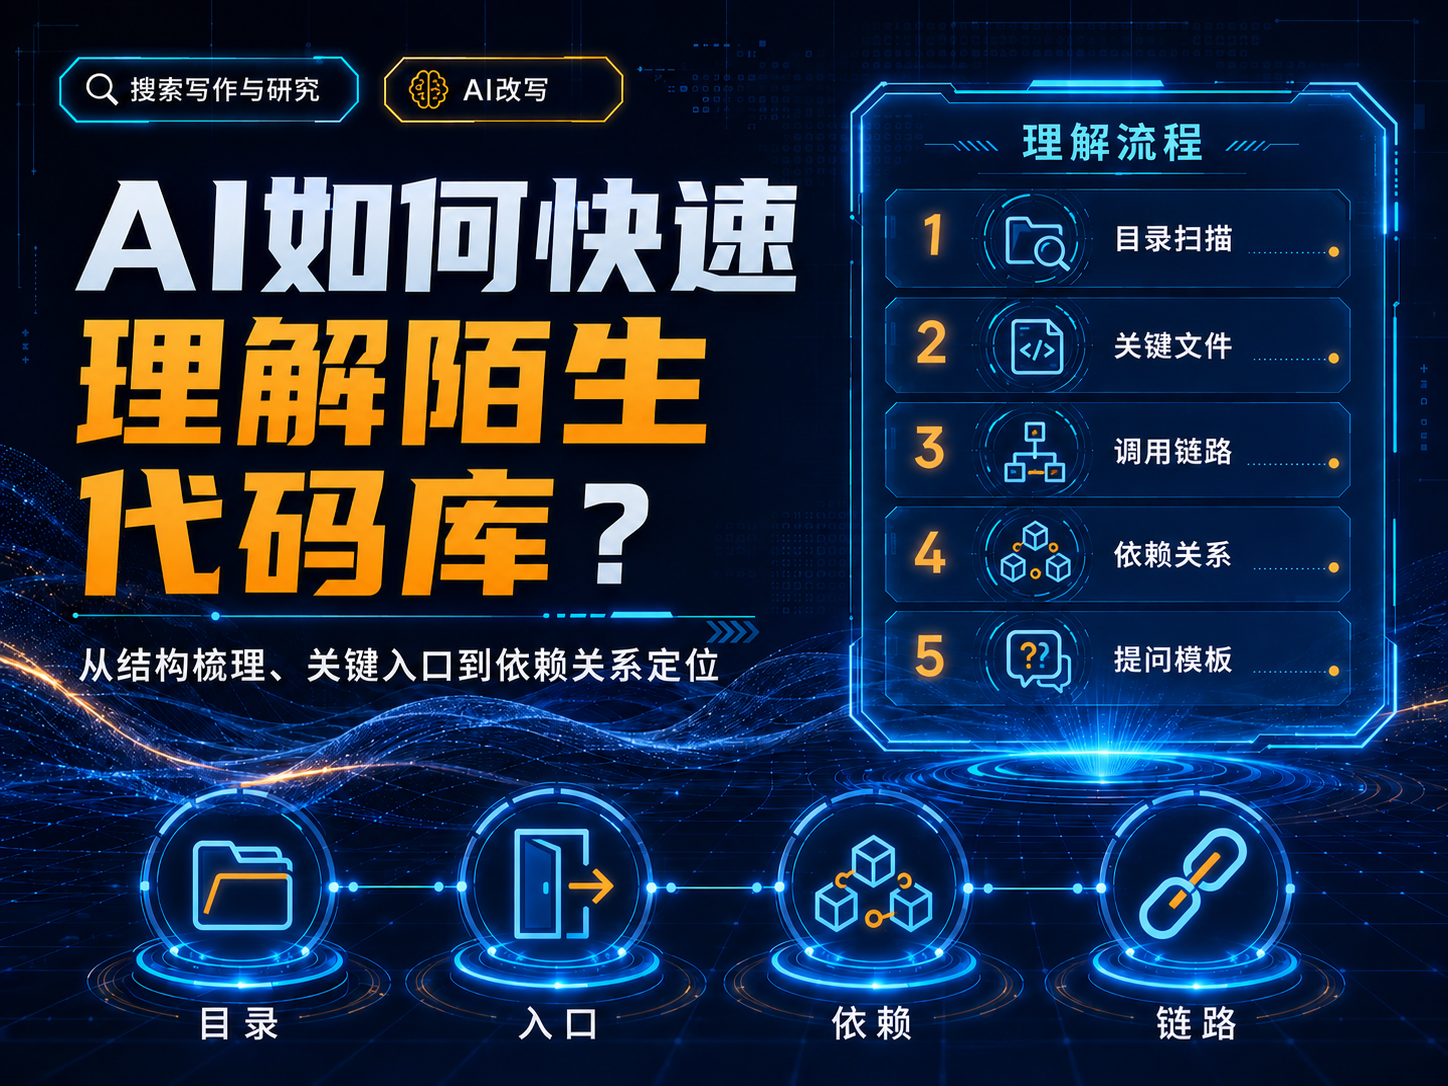
第一步:建立代码库地图
先让AI回答四个问题:项目有哪些顶级目录?入口文件在哪里?核心框架和包管理器是什么?哪些目录明显是生成代码、第三方代码或测试。GitHub官方说明,带仓库上下文的Copilot Chat会对仓库建立索引,以改善对结构和逻辑的回答;Cursor的Ask模式则用于只读搜索代码库而不自动修改。[1][2]
第二步:找到真正的启动入口
不要只看README。让AI根据package scripts、Dockerfile、CI配置、框架约定和主程序入口交叉判断。典型入口包括Web路由、CLI命令、队列消费者、定时任务和后台worker。
第三步:画依赖边界
| 边界 | 要找什么 | 为什么重要 |
|---|---|---|
| 内部模块 | 谁依赖谁、公共接口 | 避免只看文件名猜架构 |
| 外部依赖 | 数据库、缓存、消息队列、SDK | 理解副作用与运行条件 |
| 配置 | 环境变量、feature flag、secret引用 | 找出环境差异 |
| 测试 | fixture、mock、集成环境 | 理解真实行为契约 |
第四步:沿一条真实数据流追踪
选一个具体问题,例如“用户登录后首页数据从哪里来”,要求AI按入口→校验→业务服务→数据访问→外部依赖→响应列出文件和函数,并为每一步给出代码位置。OpenAI的Codex用例也把“理解大型代码库、追踪请求流和定位陌生模块”作为典型工作流。[3]
第五步:让AI输出证据,而不是故事
- 每个架构判断都附文件路径;
- 关键调用附函数/类名;
- 不确定时标“待确认”,不要补全想象;
- 如果发现两套实现,说明当前生产路径依据是什么。
一个可复制的提问模板
目标:理解这个仓库中“订单创建”完整数据流。
先不要改代码。
1. 列出你认为相关的目录和入口文件;
2. 从HTTP入口开始逐步追踪到数据库/外部服务;
3. 每一步给文件路径、函数名和作用;
4. 标记你不确定的地方;
5. 最后给一个不超过15节点的数据流图和3个验证命令。
常见误区
- 一次把全仓都塞进提示词;
- 只相信README而不看运行配置;
- 让AI先改代码再理解;
- 忽略测试,它往往比注释更接近真实行为;
- 把“文件名字像Service”当成实际架构证据。
参考来源
- GitHub Docs:Repository indexing for Copilot(核验于 2026-08-08)
- Cursor Docs:Agent Modes(核验于 2026-08-08)
- OpenAI Developers:Codex use cases(核验于 2026-08-08)
更新记录
- 2026-08-08:整理分层理解代码库的可复现工作流。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


 百度热点