直接回答:深度研究工具可以明显减少“找资料—读资料—整理报告”的人工步骤,但不能把它当作自动事实判定器。产品官方都强调多步搜索和引用,而研究论文也表明“有引用”与“引用真的支撑对应事实”是两回事。可靠使用的核心是:先控制问题和来源,再抽查搜索路径,最后逐条验证高影响结论。[1][2][3][5]
资料核验日期:2026-08-08。本文未完成所有深度研究工具统一条件下的横向实测,保留“需实测”属性。
深度研究工具到底多做了什么
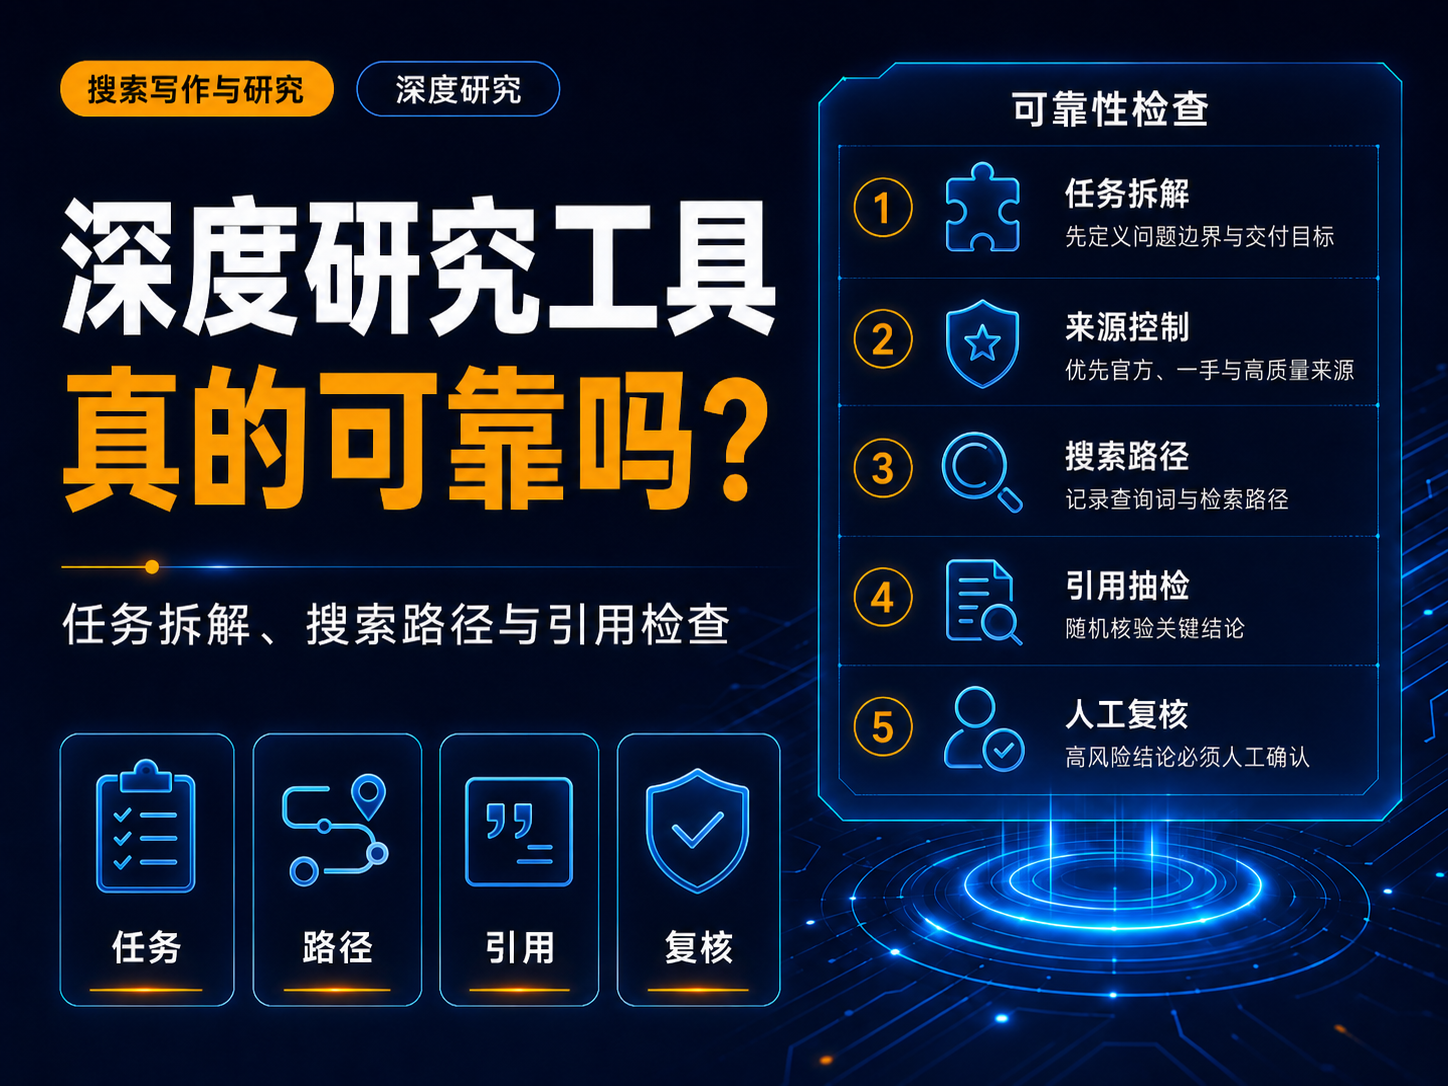
与普通联网问答相比,Deep Research类工具通常会先拆解问题,执行多轮搜索,读取多个来源,再输出结构化报告。OpenAI允许用户查看并修改研究计划、选择网站/文件/连接应用;Gemini可把Google搜索与个人Gmail、Drive、上传文件和NotebookLM组合;Claude Research需要开启Web Search,并面向多来源综合;Perplexity也提供Research模式。[1][2][3][4]
可靠性要分成四层
| 层 | 要问的问题 |
|---|---|
| 问题拆解 | 它有没有漏掉关键子问题? |
| 来源检索 | 是否找到真正重要的官方/一手资料? |
| 引用归因 | 引用链接是否与句子对应? |
| 综合结论 | 有没有把推断写成事实、忽略冲突? |
为什么“引用很多”仍可能不可靠
ALCE将引用质量单独作为评测维度,说明引用不仅要存在,还需要有足够覆盖和正确支撑。2026年的一项深度研究代理来源归因研究进一步把引用检查拆成“链接是否可访问、内容是否相关、事实是否被支持”,并发现表面有效的引用不等同于事实完全可靠。[5][6]
一套可复现的深度研究评测
- 选一个近30天发生变化、且你已人工准备关键来源的问题;
- 统一输入、语言、账号等级和研究模式;
- 运行后保存完整报告、来源列表和研究过程;
- 检查“必须找到”的来源召回率;
- 随机抽取至少20条事实声明核对引用;
- 把事实、推断、建议分开评分;
- 记录耗时、需要追问次数和人工修正时间。
怎么抽查引用
- 数字:原文数值和单位是否一致;
- 日期:是事件日期还是文章发布日期;
- 产品能力:引用的是当前版本还是旧文档;
- 比较结论:来源是否真的比较了两个对象;
- 因果关系:原文只是相关性,模型有没有写成因果。
研究路径比最终报告更重要
如果工具只围绕最早找到的一类来源搜索,后面的报告可能看似完整却存在“来源同质化”。评测时应观察是否覆盖官方、论文、独立机构和反面证据;对争议问题,还要检查它是否主动展示不同结论。
什么时候适合直接用
- 建立陌生领域的概念地图;
- 整理大量公开资料;
- 生成待核验的竞品、市场和文献初稿;
- 准备会议前背景资料。
什么时候必须人工主导
- 医疗、法律、金融等高风险决策;
- 需要精确引文、数据和合规结论;
- 内部未公开数据与公开资料混合;
- 结论会直接对外发布或用于投资采购。
最终原则
把深度研究当“研究助理”,不要当“最终审稿人”。它最擅长扩大搜索、整理和提出线索;你的责任是确定问题、选择证据等级并核验关键结论。
文章局限
- 产品持续更新,研究路径和引用机制可能变化。
- 本文不提供当前工具质量排名,因为尚未完成统一实测。
参考来源
- OpenAI:Deep Research(核验于 2026-08-08)
- Google:Gemini Deep Research(核验于 2026-08-08)
- Claude:Research(核验于 2026-08-08)
- Perplexity:Research mode(核验于 2026-08-08)
- EMNLP 2023:ALCE Citation Evaluation(核验于 2026-08-08)
- 2026研究:Cited but Not Verified(核验于 2026-08-08)
更新记录
- 2026-08-08:首次整理并核验官方或一手资料,形成可复用流程。
如果你想系统比较AI搜索、Deep Research、学术检索和引用核验工具,可以继续查看:AI搜索与研究专题 →
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章



 百度热点