直接回答:主流AI搜索工具不要只看“回答是否聪明”,应统一测试六个维度:关键来源覆盖、来源类型、引用是否支持结论、时效性、深度研究能力、文件/连接器范围。当前ChatGPT支持Search和Deep Research;Gemini Deep Research默认可用Google搜索并可加入Gmail/Drive、文件和NotebookLM;Perplexity提供Pro Search与Research;Claude提供Web Search与Research;Grok也提供Web/X等实时搜索与研究能力。[1][2][3][4][5]
产品资料核验日期:2026-08-08。本文尚未完成所有工具在相同账号等级、相同网络与相同任务下的统一实测,因此不做“谁最好”的排名。
先分清三种AI搜索
- 快速搜索:回答当前问题,通常数秒到数十秒完成。
- Pro/增强搜索:多次查询、更多来源、更复杂推理。
- Deep Research:先规划问题,再执行多步搜索并输出较长的带引用报告。
如果把三种模式混在一起比较,结果会失真:深度研究本来就更慢、用更多检索步骤,也可能有更高用量成本。
当前主流候选怎么理解
| 产品 | 官方可确认能力 | 统一实测要重点看 |
|---|---|---|
| ChatGPT | Search;Deep Research可选网站、上传文件和连接应用 | 官网召回、引用匹配、研究计划可控性 |
| Gemini | Deep Research默认使用Google搜索,可加入Gmail、Drive、文件、NotebookLM | Google生态整合、多来源归因 |
| Perplexity | Pro Search支持Web、Academic、Finance、Files等范围;Research用于深入研究 | 来源覆盖、学术/专业数据、引用质量 |
| Claude | Web Search与Research,Research依赖Web Search并输出可检查引用 | 搜索路径、长报告结构、引用支撑 |
| Grok | Web与X实时搜索、研究综合和来源归因 | 实时信息、X来源占比、外部官网覆盖 |
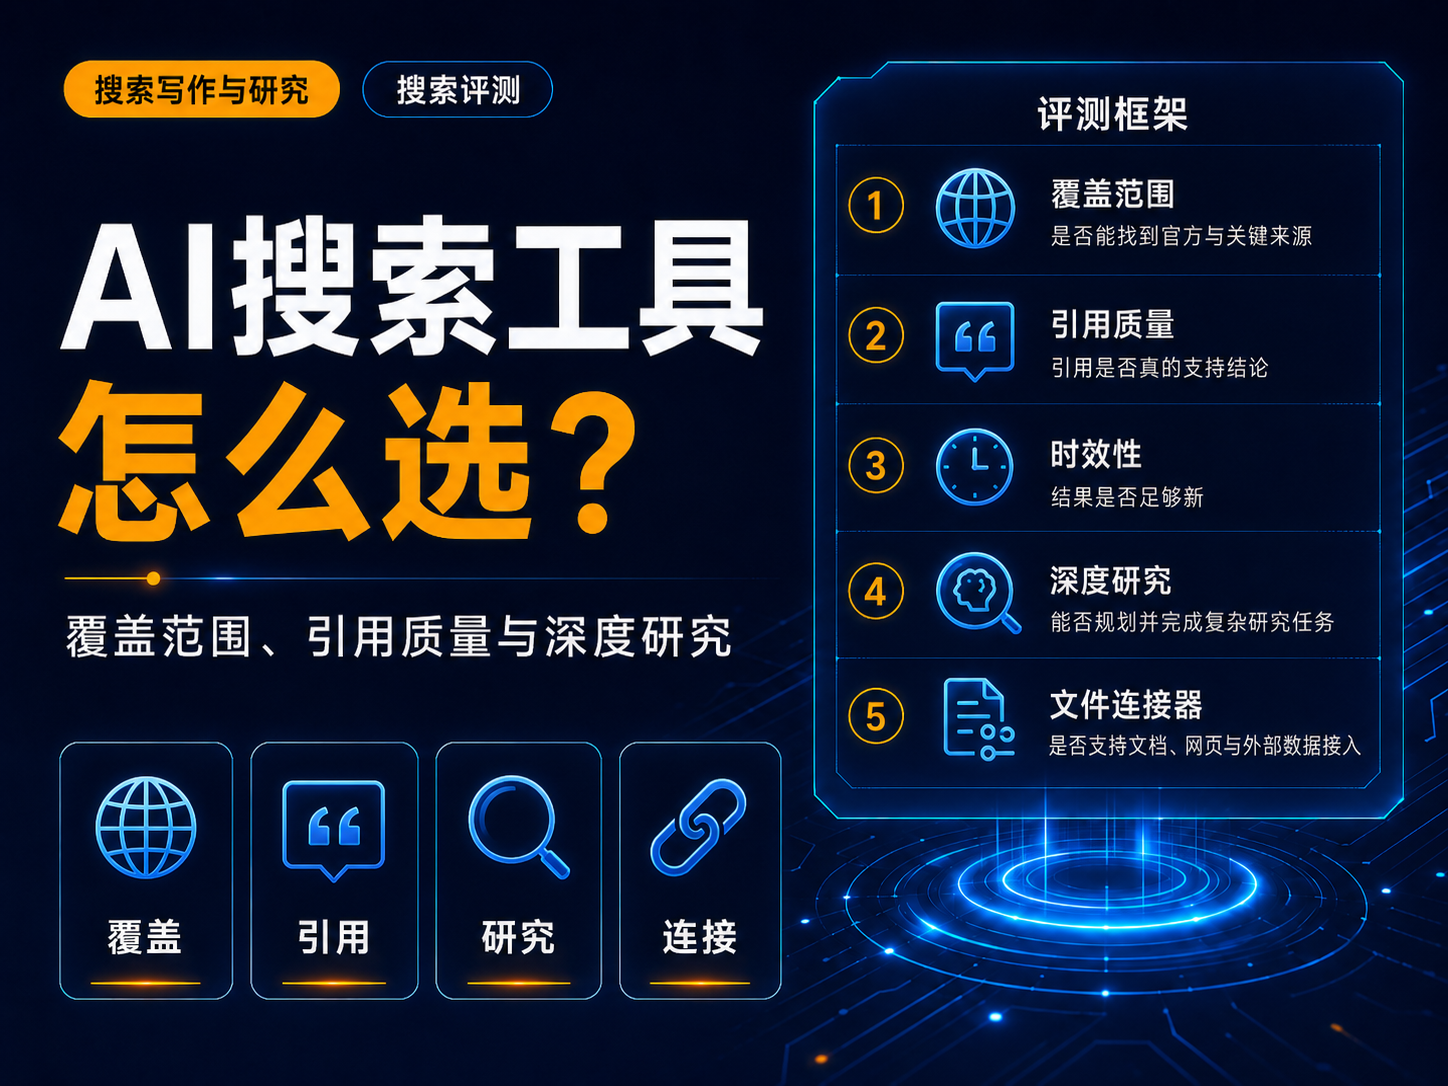
六项评测指标
1. 关键来源覆盖
先为每个问题人工列出3—5个“必须找到”的官方或一手来源,再看工具有没有召回。只看来源数量会误导:搜到30个转载站,不如搜到1个真正官方公告。
2. 来源类型
记录官方、论文、媒体、论坛、社交平台、内容聚合站各占多少。不同任务应有不同合理分布。
3. 引用匹配
随机抽取关键结论,点击引用并检查原文是否直接支持,而不是仅仅主题相关。
4. 时效性
对近期事件记录“事件发生时间、来源发布时间、工具引用时间”。搜索到旧页面并不代表答案错,但如果漏掉关键更新,就不适合实时研究。
5. 深度研究路径
看工具能否先拆问题、覆盖不同角度、识别冲突,而不是围绕第一个结论反复搜索相似网页。
6. 输入范围
研究经常不仅来自公网,还包括PDF、Drive、邮件、企业知识库。官方文档表明不同产品的来源接入范围明显不同。[1][2]
建议统一测试题
- 一个最近30天发生变化的产品/政策问题;
- 一个需要找到官方价格和限制的问题;
- 一个需要论文和行业资料共同支撑的问题;
- 一个存在相互冲突来源的问题;
- 一个带本地文件或内部资料的问题。
评分模板
| 指标 | 建议权重 |
|---|---|
| 关键来源召回 | 25% |
| 引用匹配 | 25% |
| 事实/日期准确 | 20% |
| 研究完整性 | 15% |
| 速度与使用成本 | 10% |
| 可编辑与导出 | 5% |
文章局限
- 本文是选型与评测框架,不是统一实测排行榜。
- 模式、套餐、模型、搜索源和限额变化很快。
- 任何工具的引用都应抽查原文。
参考来源
- OpenAI:ChatGPT Search(核验于 2026-08-08)
- OpenAI:Deep Research(核验于 2026-08-08)
- Google:Gemini Deep Research(核验于 2026-08-08)
- Perplexity:Pro Search(核验于 2026-08-08)
- Claude:Web Search(核验于 2026-08-08)
- xAI:Research Synthesis(核验于 2026-08-08)
更新记录
- 2026-08-08:首次整理并核验官方或一手资料,形成可复用流程。
如果你想系统比较AI搜索、Deep Research、学术检索和引用核验工具,可以继续查看:AI搜索与研究专题 →
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


 百度热点