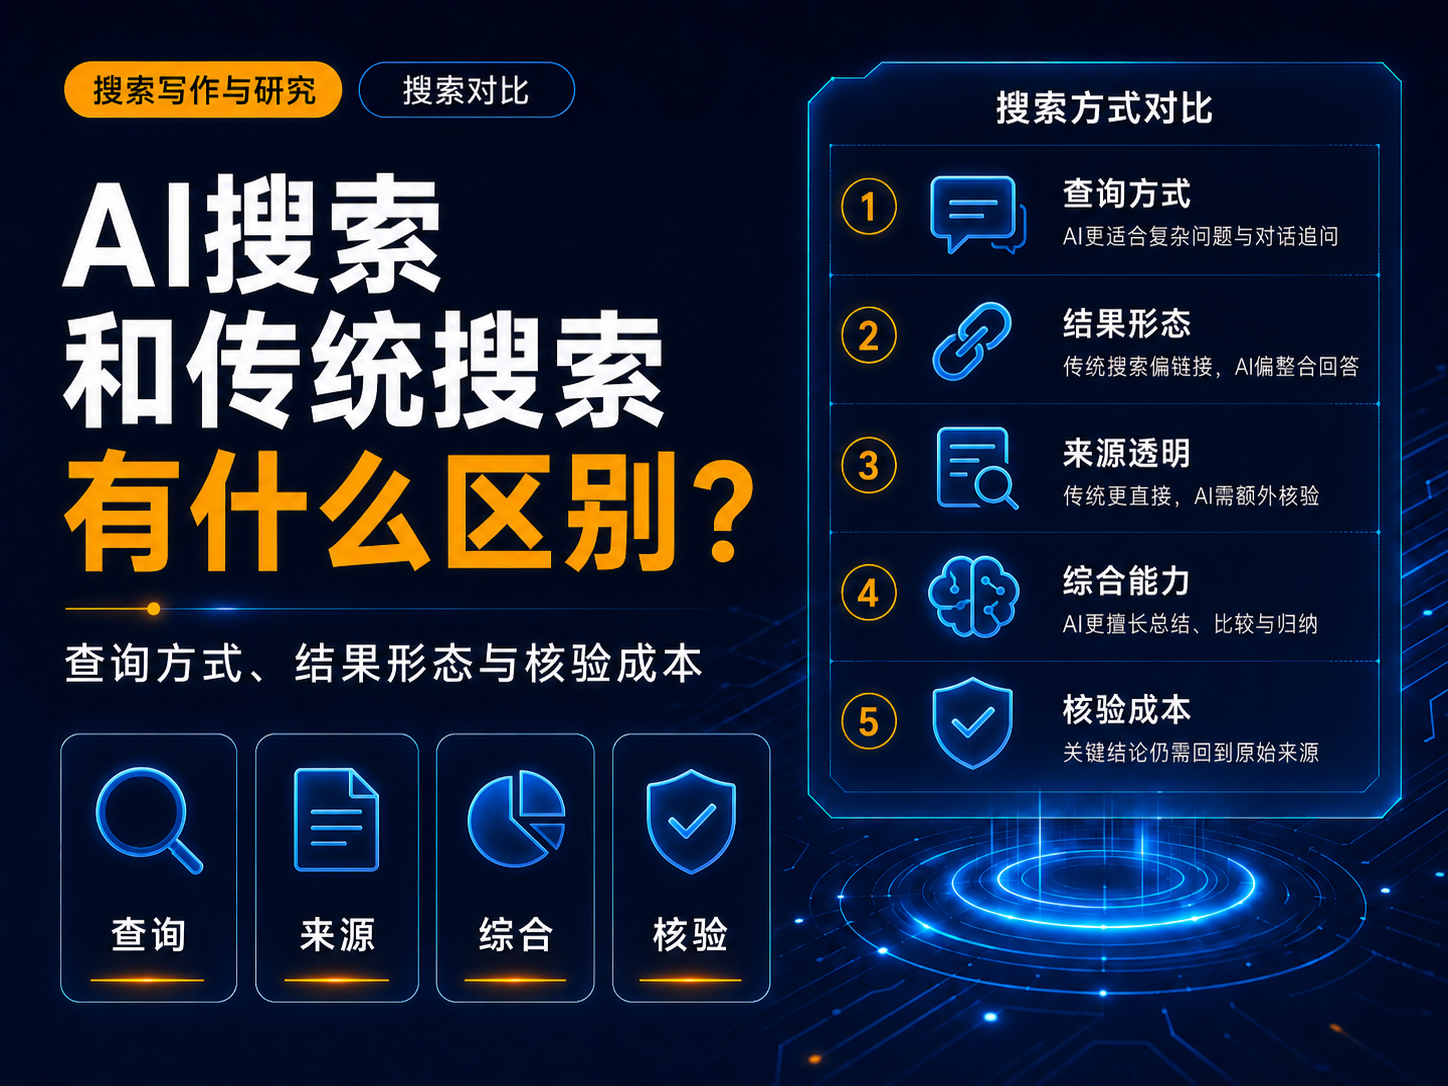
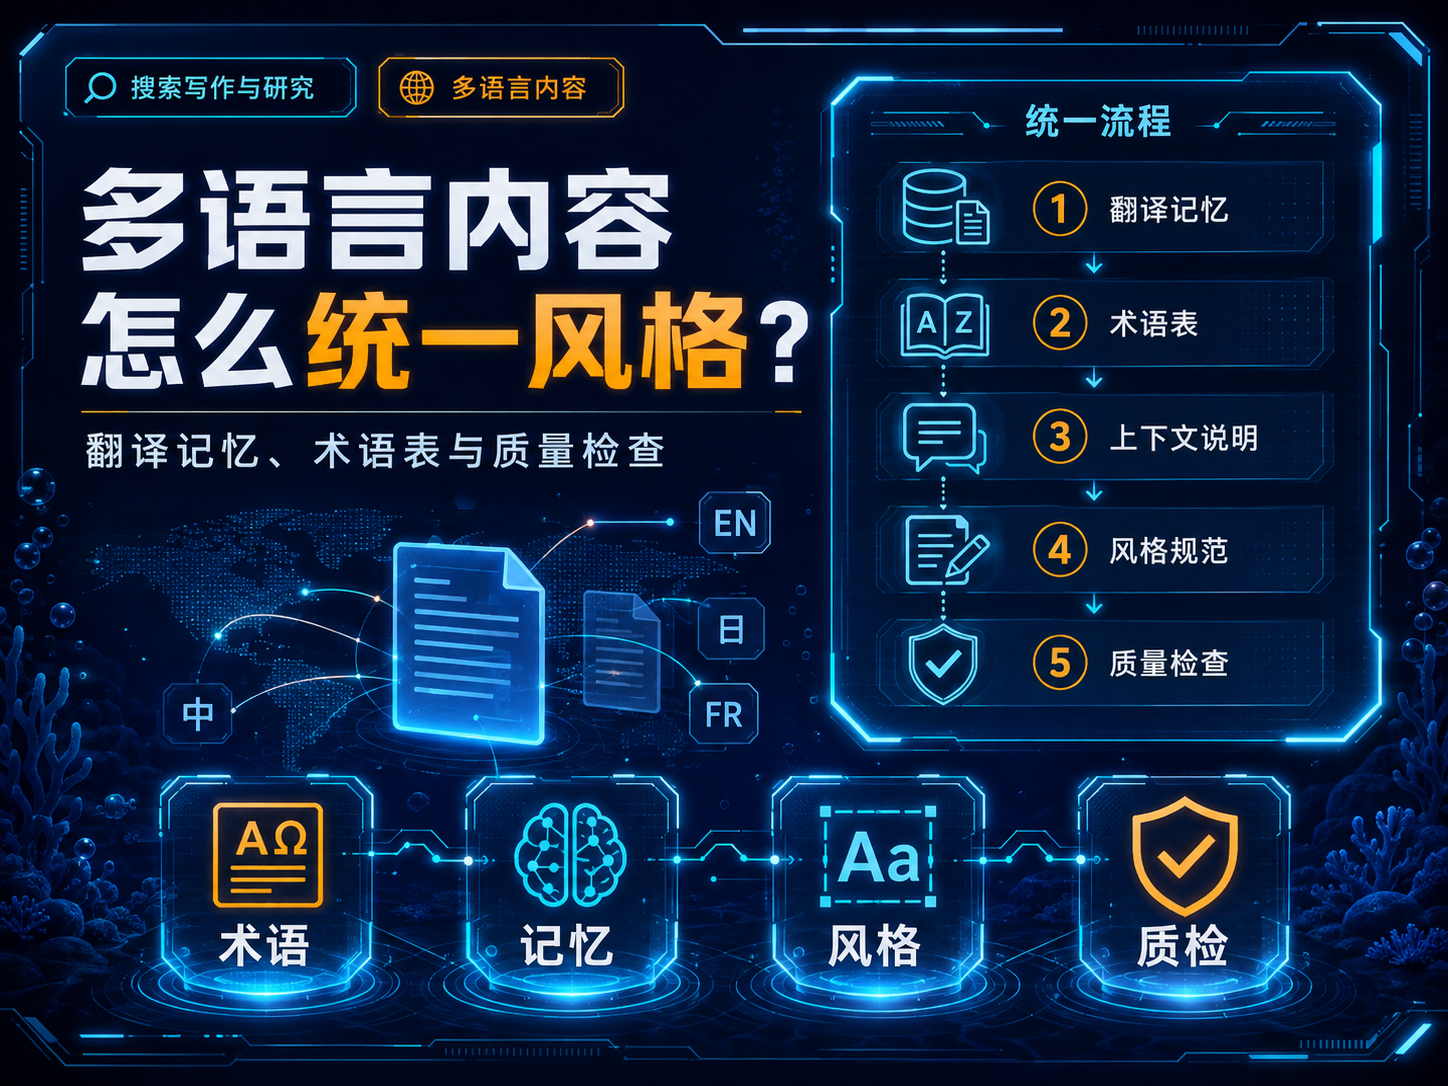
直接回答:多语言内容想保持统一,至少要同时管理翻译记忆(TM)、术语表(Glossary)、上下文、品牌风格规范和质量检查。术语表解决“某个词必须怎么翻”,翻译记忆解决“以前这句话或相似句怎么翻”,上下文解决“一句话到底是什么意思”,品牌规范解决“整篇应该怎么说”。只固定一个翻译模型,并不能自动保证长期一致。
资料核验日期:2026-08-08。不同翻译平台对TM、Glossary和文档格式支持会调整,接入前应再次检查官方文档。
先分清四个容易混在一起的东西
| 资产 | 解决的问题 | 典型内容 |
|---|---|---|
| 术语表 | 固定词级翻译 | 产品名、行业术语、功能名 |
| 翻译记忆 | 复用已有句段 | 界面文案、帮助中心、重复合同条款 |
| 上下文 | 消除歧义 | 页面用途、受众、前后句 |
| 风格指南 | 统一语气 | 正式度、称谓、标点、数字、禁用表达 |
DeepL官方API支持Glossary和context参数,并说明context可帮助处理歧义;其文档也提供Translation Memory相关能力。Trados的官方开发文档则把创建、维护、检索和导入导出翻译记忆列为TM核心功能。[1][2][3]
第一步:先建立“最小术语表”
不要一开始收集几千个词。先从最容易出错、最影响品牌的词开始:
- 产品、套餐、功能、按钮名称;
- 行业专有名词及缩写;
- 公司、组织、人物固定译名;
- 不能翻译或必须保留英文的词;
- 容易有多个译法但必须统一的词。
推荐字段:source_term|target_term|language_pair|definition|context|do_not_translate|example|owner|updated_at。
第二步:翻译记忆不要和术语表混用
术语表是词级约束,翻译记忆是句段级复用。页面按钮、固定邮件、常见帮助中心问答这类重复率高的内容,使用TM能明显减少同一句话被不同人翻成不同版本。DeepL官方示例说明,当源文本命中Translation Memory时,可以复用已存翻译。[3]
第三步:把上下文一起送入翻译流程
短句最容易误译。例如“Charge”在支付、设备、电池和法律文本里含义完全不同。翻译时至少附上页面类型、用户动作、上一句/下一句和产品领域。DeepL官方把context参数专门用于帮助翻译歧义短文本。[2]
第四步:品牌风格要独立于翻译工具
Mailchimp的“Writing for Translation”强调,面向国际读者时应减少容易误解的语言,并考虑正式/非正式语气等本地化差异。[4] 团队应维护一份与供应商无关的风格表:称谓、句长、主动/被动、数字格式、日期格式、标点、大小写、禁用词、是否保留英文品牌词。
第五步:质量检查至少做六项
- 术语命中率:强制术语是否全部按表翻译;
- 数字一致:金额、百分比、日期、版本号是否变化;
- 漏译/多译:原文句段数量与译文对应;
- 格式保留:链接、变量、Markdown、HTML标签是否被破坏;
- 语气一致:同类页面是否出现正式度漂移;
- 反向抽检:高风险段落由人工或第二流程回译核对。
多语言内容的推荐版本结构
| 字段 | 建议 |
|---|---|
| content_id | 同一内容跨语言共享ID |
| source_version | 记录源文版本 |
| target_language | 明确地区变体,如en-US/en-GB |
| translator/tool | 记录人工或工具来源 |
| glossary_version | 记录使用哪版术语表 |
| review_status | 机器初稿/人工校对/发布 |
参考来源
- DeepL:Create a glossary(核验于 2026-08-08)
- DeepL:Context parameter(核验于 2026-08-08)
- DeepL:Translation memories(核验于 2026-08-08)
- Mailchimp:Writing for Translation(核验于 2026-08-08)
- RWS Trados:Translation Memory API Overview(核验于 2026-08-08)
更新记录
- 2026-08-08:核验术语表、上下文和翻译记忆的官方能力说明。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


 百度热点