直接回答:读论文PDF最有效的方法不是让AI“总结全文”,而是分两遍:第一遍确认论文身份、研究问题和整体结构;第二遍按“方法—结果—局限—可复用证据”结构化提取,并要求每个关键结论保留页码、表格编号或原文片段。DOI、PMID等标识用于确认你读的是哪篇、哪个版本。[1][2]
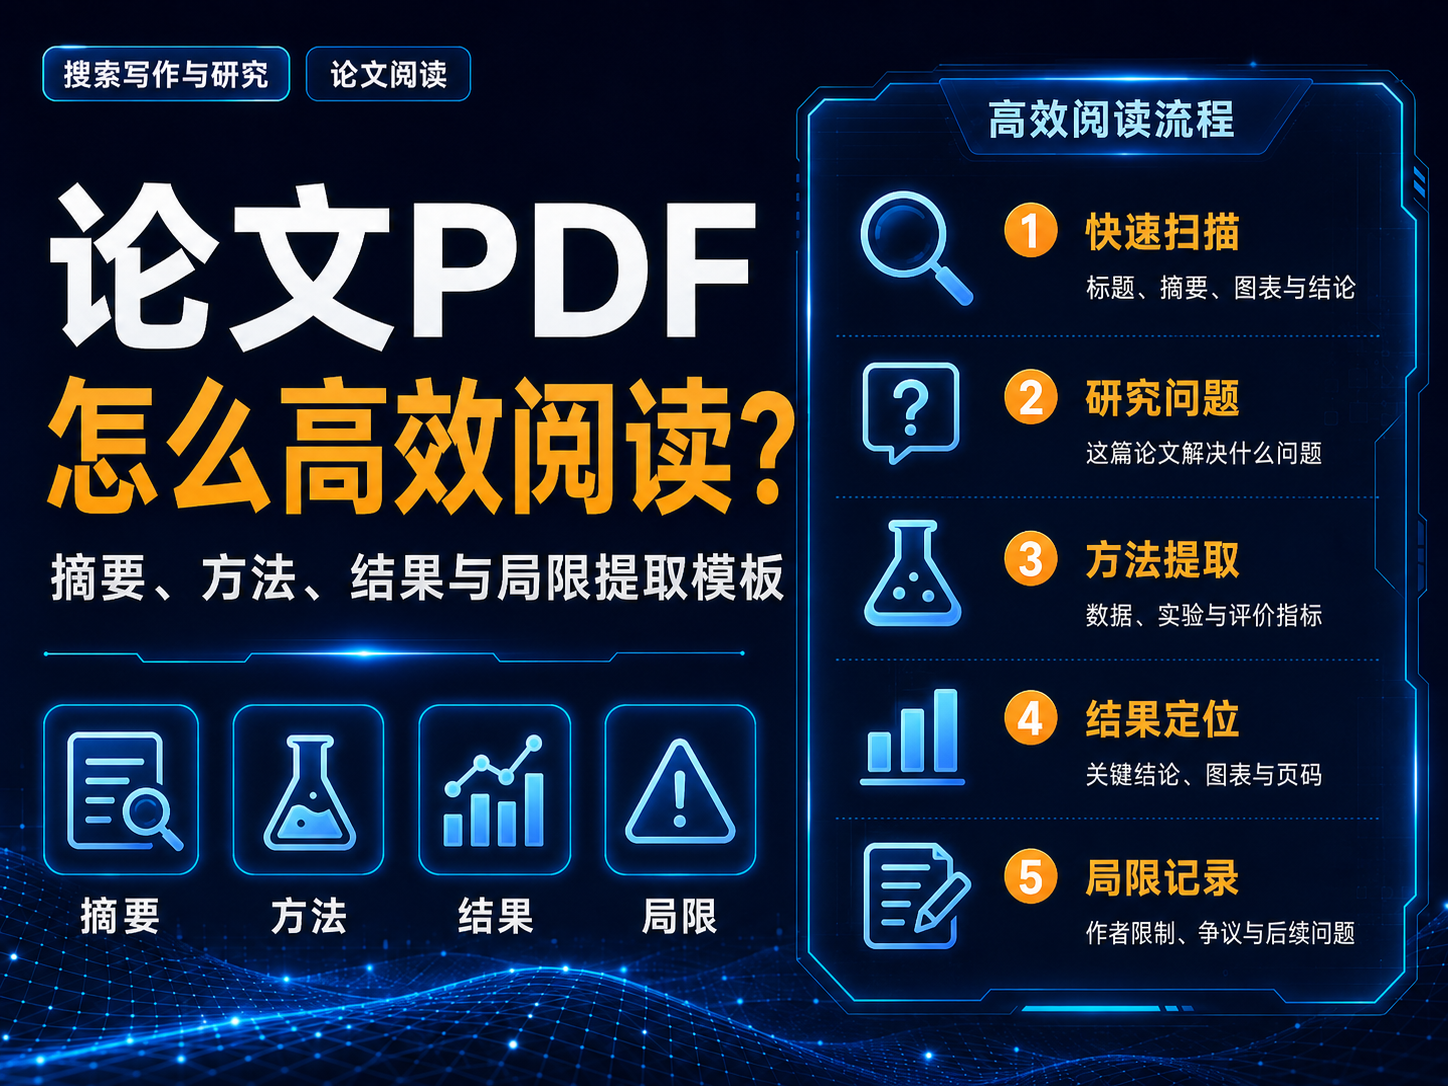
第一遍:5分钟完成结构扫描
- 确认标题、作者、年份、期刊和DOI;
- 读摘要,写出一句话研究问题;
- 看目录、小标题、图表和结论;
- 判断是否值得精读;
- 记录你真正想从这篇论文得到什么。
PubMed记录可包含MeSH、出版类型和文章标识,Crossref可通过DOI核验元数据。[1][2] 先确认身份能避免把预印本、会议摘要和正式版本混在一起。
第二遍:按六个问题精读
| 问题 | 要提取什么 |
|---|---|
| 为什么研究? | 背景、研究空白、假设 |
| 研究谁/什么? | 样本、数据、对象、场景 |
| 怎么研究? | 设计、变量、实验/统计方法 |
| 发现了什么? | 主要结果、效应、图表 |
| 作者怎么解释? | 机制、讨论、与已有研究关系 |
| 哪里不能外推? | 局限、偏倚、边界条件 |
不要把摘要当论文
摘要主要用于快速判断是否相关,很多方法细节、结果限制、负面结果和补充材料不会完整出现在摘要中。AI读论文时至少要把“摘要中的说法”和“正文证据”分开。
结果段最容易出现三种误读
- 把相关性写成因果:观察性结果不等于因果关系。
- 只看显著性:同时记录效应大小、区间和实际意义。
- 忽略分组与样本:总体结论可能不适用于某个子群。
一份可直接复用的论文提取模板
文献信息:标题|作者|年份|DOI/PMID
一句话问题:作者到底要回答什么?
方法:样本|设计|变量|分析方法
核心结果:结果1/2/3 + 页码/表格
局限:作者自述 + 你发现的边界
可引用原文:短句 + 页码
我的判断:这篇论文能支持什么、不能支持什么。
让AI回答时的正确格式
要求AI把“原文事实”“作者解释”“AI归纳”分三列输出,并对无法定位的内容明确写“未找到”。这样能显著降低把模型推断误当原文的风险。
最后做一次反向检查
- 你的摘要有没有遗漏相反结果?
- 每个数字能否在表格或正文找到?
- 局限是否真实存在于论文,而不是AI想象?
- 引用的版本是否和DOI元数据一致?
文章局限
- 不同学科论文结构不同,模板需按研究设计调整。
- 扫描PDF、公式、复杂表格和补充材料可能需要专门OCR或文档解析工具。
- AI适合辅助定位和整理,不替代研究方法判断。
参考来源
- PubMed:Help(核验于 2026-08-08)
- Crossref:REST API(核验于 2026-08-08)
更新记录
- 2026-08-08:首次整理并核验官方或一手资料,建立可复用流程与检查清单。
如果你想系统比较AI搜索、Deep Research、学术检索和引用核验工具,可以继续查看:AI搜索与研究专题 →
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


 百度热点