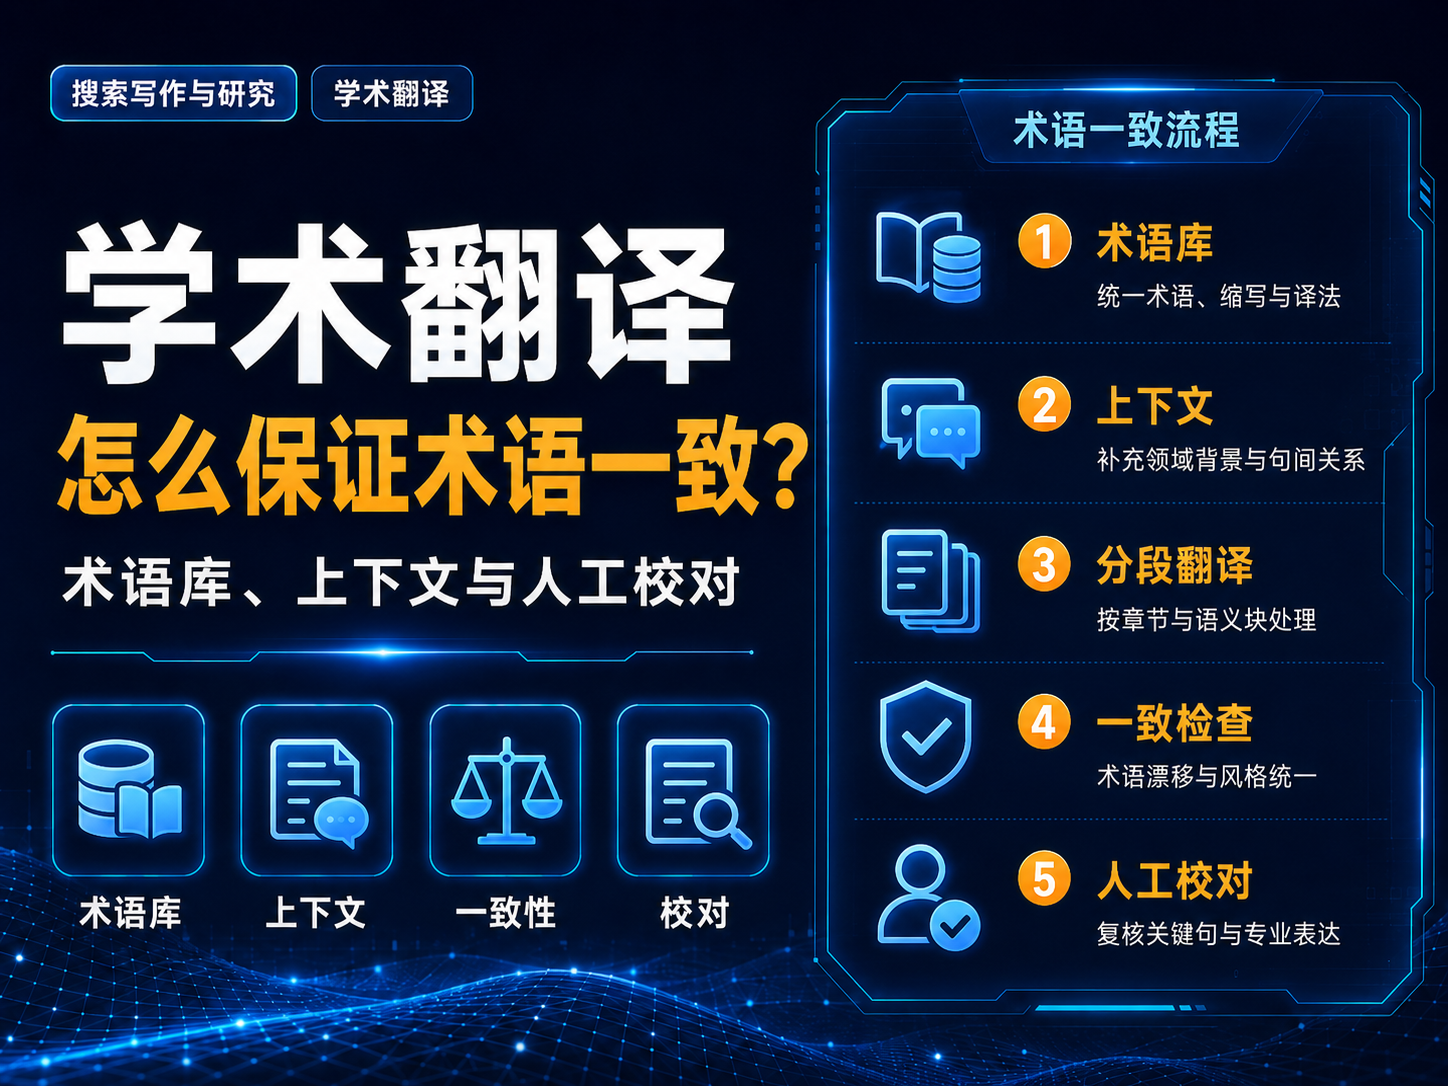
直接回答:学术翻译要保证术语一致,关键不是把temperature调低,而是把术语从正文中“抽离出来管理”:先建立双语术语库,明确缩写、专名和不翻译项;翻译时提供章节上下文;全文完成后再做术语一致性扫描和人工校对。DeepL与Azure Translator的官方文档都把Glossary/Dictionary作为控制专用术语翻译的重要机制。[1][2]
先建立一份最小术语库
术语库至少包含:源术语、目标术语、词性/含义、是否区分大小写、是否允许变体、首次出现时是否解释、来源。
| 源术语 | 固定译法 | 备注 |
|---|---|---|
| retrieval-augmented generation | 检索增强生成 | 首次出现可加RAG |
| ground truth | 真实标注/基准真值 | 按学科约定固定一种 |
| OpenAI | OpenAI | 品牌名不翻译 |
DeepL Glossary要求每个源条目对应偏好的目标译法;Azure文档翻译也允许通过Glossary约束术语。[1][2]
术语不要孤立翻译,要给上下文
同一个英文词在不同学科可能有不同译法。翻译前先向AI提供:论文领域、目标读者、已有术语表、上一段/下一段摘要、文体要求。Microsoft Custom Translator对Dictionary的说明也强调定制词典会与上下文共同作用。[3]
推荐四阶段工作流
- 预处理:抽取术语、缩写、人名、机构名、公式、变量名;
- 分段翻译:按自然段或章节翻,不要切成完全失去上下文的单句;
- 全局一致性检查:扫描同一源术语是否出现多个译法;
- 人工校对:检查学科含义、因果强度、数字、否定词和引用。
必须单独检查的六类内容
- 缩写第一次出现是否定义;
- 同一变量名是否前后变化;
- 图表标题和正文术语是否一致;
- 专有名词是否被错误意译;
- 否定词、比较级、概率词是否弱化或强化;
- 引文、参考文献、DOI是否被改写。
自动一致性检查怎么做
把源文和译文分段对齐,统计术语表中每个源术语在译文中的目标译法。若一个术语出现两个以上译法,自动标红;对“可接受变体”单独白名单。这个方法比让AI重新读全文问“有没有问题”更可复现。
什么时候不能只靠机器翻译
- 法律、医学、工程标准等错误代价高的文本;
- 涉及新概念、双关或理论术语的文本;
- 投稿论文最终版本;
- 需要保持作者风格和修辞关系的长篇人文内容。
文章局限
- 不同期刊和学科有自己的术语约定,应优先服从目标领域规范。
- Glossary能提升一致性,但不能自动解决语义歧义。
- 最终责任仍在译者和作者,尤其是研究结论与风险表述。
参考来源
- DeepL:About the glossary(核验于 2026-08-08)
- Microsoft Azure Translator:Create and use a glossary(核验于 2026-08-08)
- Microsoft Custom Translator:Dictionaries(核验于 2026-08-08)
更新记录
- 2026-08-08:首次整理并核验官方或一手资料,建立可复用流程与检查清单。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


 百度热点