直接回答:自动生成每日AI简报,应该把系统拆成“定时触发 → 来源采集 → 字段标准化 → 去重聚类 → 来源分级 → 关键事实核验 → 摘要与评分 → 人工/规则门槛 → 推送 → 日志与失败重试”。真正决定质量的是前面的来源、去重和核验,不是最后那一步让大模型写摘要。
资料核验日期:2026-08-08。本文给出平台无关的方法,可用n8n、Make、自建脚本或其他自动化工具实现。
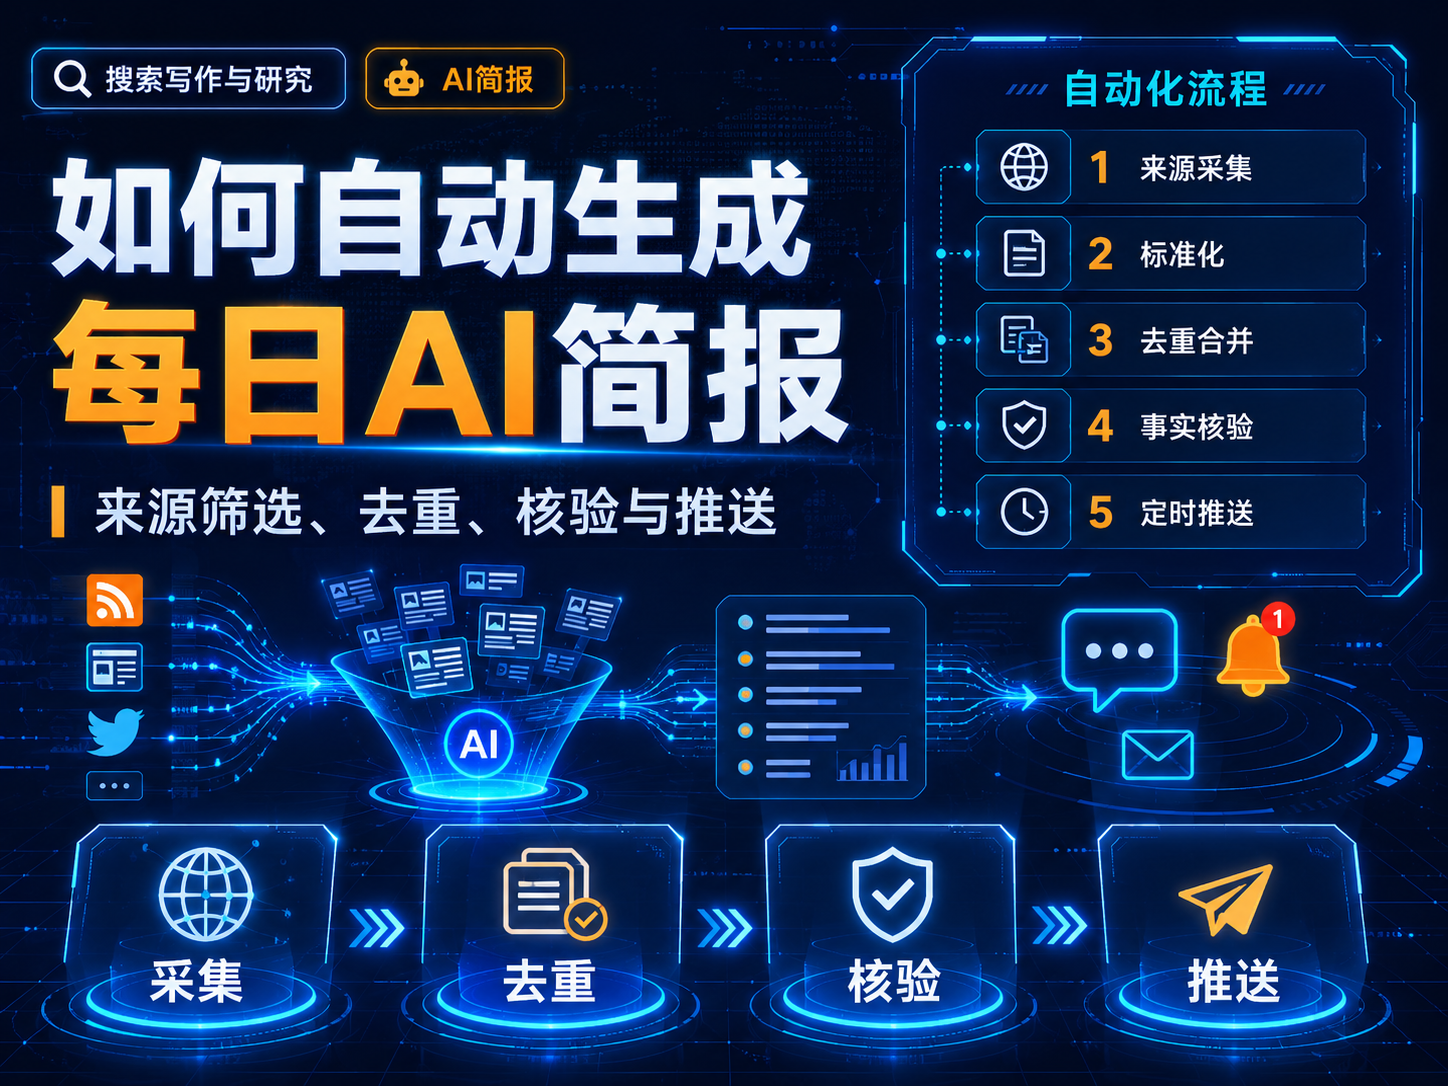
第一步:建立来源白名单
| 级别 | 来源 | 用途 |
|---|---|---|
| A | 官方博客、官方文档、官方GitHub、论文、监管机构 | 支撑关键事实 |
| B | 高质量媒体、专业机构 | 补充背景 |
| C | 社交媒体、社区、二次转载 | 发现线索,不单独支撑结论 |
第二步:统一采集字段
source_url
title
published_at
fetched_at
source_domain
source_level
author
guid_or_id
raw_text
language
topic
优先使用RSS、官方API和结构化页面,不要每次都让模型重新“搜全网”。自动化平台如n8n包含Schedule Trigger、RSS Read等节点,可用于定时抓取信息源。[1]
第三步:先做确定性去重,再做语义聚类
去重分两层:
- 硬去重:URL、GUID、标题规范化、正文哈希;
- 事件聚类:不同媒体报道同一发布事件,保留一条主记录并关联其他来源。
不要把“10家媒体转载同一新闻”算成10条重要新闻。
第四步:重要新闻必须回到一手来源
如果二手媒体说“某模型发布”“某价格下降”“某功能上线”,系统应尝试找到官方发布页或文档。找不到时,在简报里标注“尚未找到官方确认”,而不是把二手消息写成确定事实。
第五步:摘要必须结构化
| 字段 | 作用 |
|---|---|
| 一句话发生了什么 | 事实 |
| 为什么重要 | 编辑判断 |
| 适合谁关注 | 用户匹配 |
| 原始来源 | 核验 |
| 不确定项 | 风险提示 |
| 发布时间 | 时效判断 |
第六步:按“重要性 × 可信度 × 新鲜度 × 个性匹配”排序
不要只按热度。一个爆火但未经官方确认的传闻,应该低于一个直接影响开发者价格、API或政策的官方更新。
第七步:推送前加门槛
建议门槛:关键事实至少有1个A类来源;来源日期不为空;主链接可访问;重复事件已合并;摘要中的数字全部能在来源里找到;若是推断必须明确写“可能/推测”。
第八步:保存运行日志
- 每次抓了多少条;
- 去重后剩多少;
- 哪些来源失败;
- 哪些条目因证据不足被拦截;
- 推送是否成功;
- 用户点击/收藏哪些主题。
这样第二天才能优化,而不是每天重新生成一个不可解释的“AI黑盒简报”。
参考来源
- n8n Docs:Schedule Trigger(并可结合RSS Read等节点)(核验于 2026-08-08)
- n8n Docs:Workflow automation documentation(核验于 2026-08-08)
更新记录
- 2026-08-08:建立来源分级、去重聚类、核验和推送日志流程。
如果你还想系统比较AI自动化平台、Agent工作流、自托管、错误恢复和安全设计,可以继续查看:AI自动化工具专题 →
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


 百度热点