直接回答:研究资料沉淀成个人知识库,不要从“我要用什么软件”开始,而要先确定一个最小数据模型:来源(Source)→ 笔记(Note)→ 标签(Tag)→ 实体(Entity)→ 关系(Relation)→ 检索(Search)。任何结论都能回到原始来源,任何资料都能通过主题、人物/公司/概念或全文搜索重新找到,这个知识库才真正可复用。
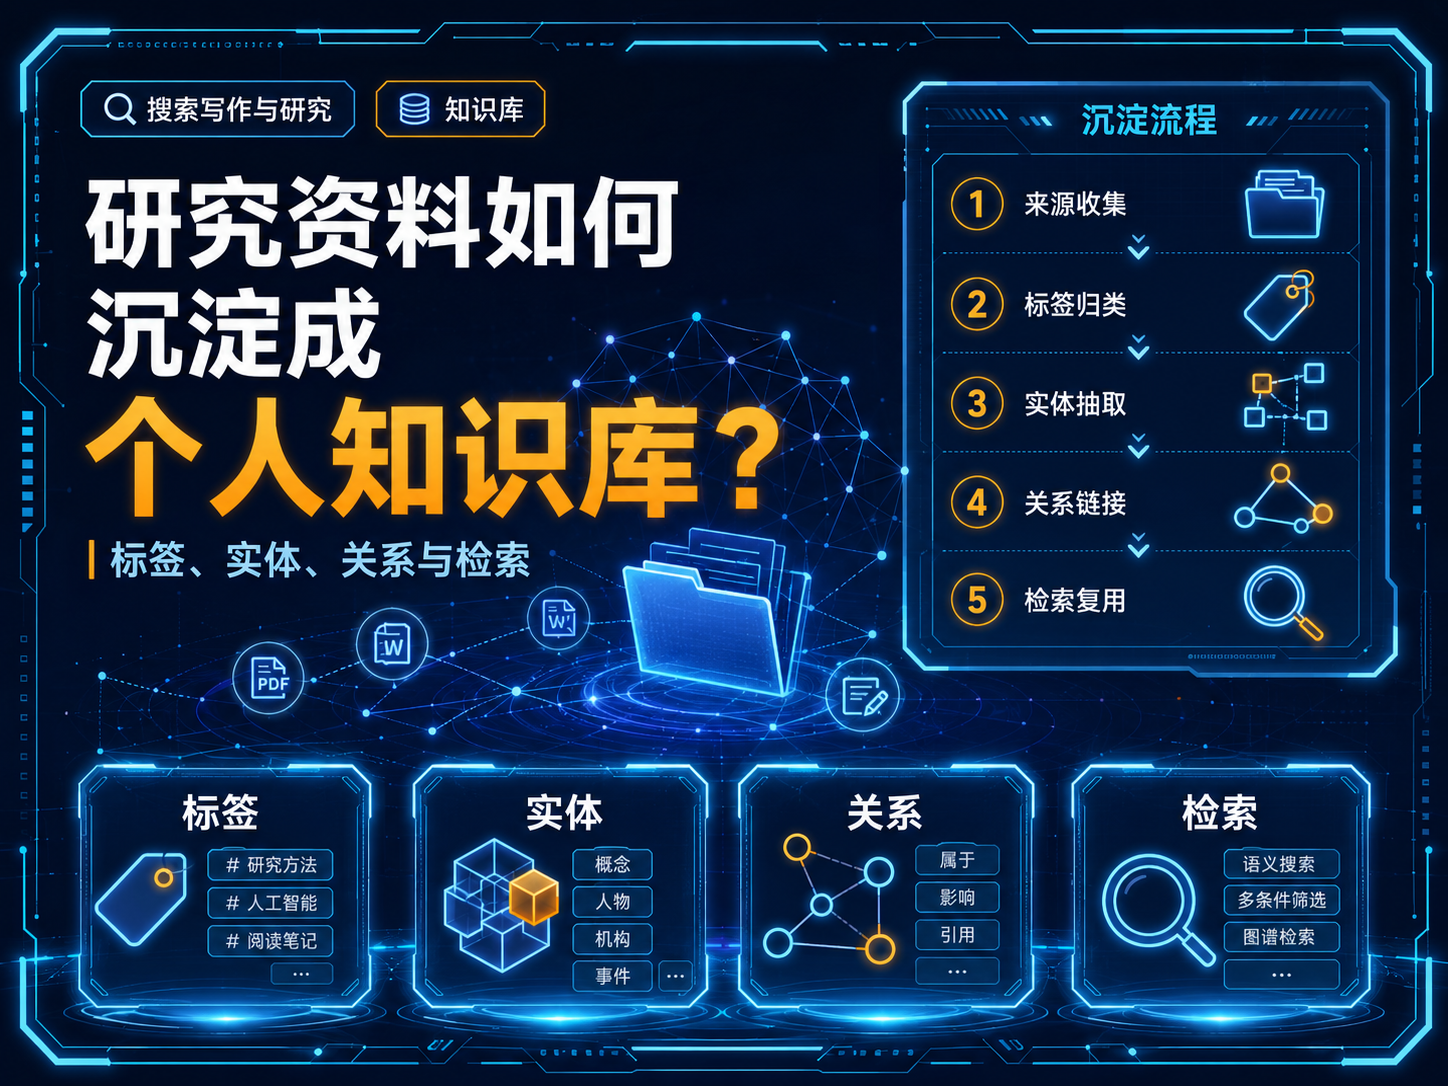
第一层:Source——原始来源永远保留
每份资料至少保存标题、作者、日期、URL/DOI、访问时间、来源类型和附件。Zotero官方把文献条目、附件和笔记作为库的核心对象,并强调常规条目具有引用所需元数据。[1]
第二层:Note——把“收藏”变成你的理解
不要把整篇原文复制进笔记。推荐三类笔记:
- 来源笔记:这篇资料说了什么;
- 观点笔记:你同意/不同意什么;
- 项目笔记:这条信息可以用于哪个任务。
Zotero官方Notes支持子笔记、独立笔记、标签、关系和搜索,说明这些对象可以组成可追溯的研究网络。[2]
第三层:Tag——标签描述维度,不要当文件夹
Zotero的Collections与Tags文档把Collection用于项目/主题分组,把Tag用于更细的描述和筛选;同一条目可以有多个标签。[3] 个人知识库可以把标签分成:
| 标签类型 | 示例 |
|---|---|
| 主题 | #AI搜索 #WordPress |
| 方法 | #访谈 #A-B测试 |
| 状态 | #待读 #已核验 #待引用 |
| 用途 | #选题 #产品需求 #视频脚本 |
第四层:Entity——把关键对象标准化
实体不是随手标签,而是有固定身份的对象,例如公司、产品、人物、论文、法规、项目。建议字段:entity_id、name、aliases、type、source、notes。这样“OpenAI”“Open AI”“openai”不会被当成三个对象。
第五层:Relation——记录“为什么有关”
Zotero支持Related Items,并且关系是双向的。[4] 在自己的知识库里,可以定义更明确的关系:A推出B、A引用B、A与B竞争、A反驳B、文章X用于项目Y。关系必须有类型,不要只有一堆无语义双链。
第六层:Search——最终目标是“找得回来”
Zotero官方支持元数据、标签和全文搜索,也支持Advanced Search与Saved Search。[5] 所以知识库上线前应测试:
- 记得标题时能否找到;
- 只记得一句正文时能否全文搜到;
- 只记得人物/公司时能否通过实体找到;
- 只记得用途时能否通过状态/项目标签找到。
一个最小可用字段表
source_id
title
author_or_org
published_at
url_or_doi
source_type
tags[]
entities[]
relations[]
summary
key_quotes[]
my_notes
verification_status
projects[]
updated_at
AI适合在知识库里做什么
- 自动建议标签和实体候选;
- 从笔记中抽取关系候选;
- 生成摘要,但必须保留来源;
- 自然语言搜索后返回“答案+来源列表”;
- 发现冲突信息和需要更新的旧资料。
不要让AI成为唯一存储层。原始资料、元数据和人工确认的关系应独立保存。
参考来源
- Zotero:Quick Start Guide(核验于 2026-08-08)
- Zotero:Notes(核验于 2026-08-08)
- Zotero:Collections and Tags(核验于 2026-08-08)
- Zotero:Related Items(核验于 2026-08-08)
- Zotero:Searching(核验于 2026-08-08)
更新记录
- 2026-08-08:建立来源、笔记、标签、实体、关系和检索六层模型。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


 百度热点