直接回答:AI分析用户访谈最适合做四件事:转写清洗、初始编码建议、相似编码聚类、证据表整理;最不应该自动接管的是“主题到底意味着什么”和“能否代表用户群体”。Braun与Clarke的主题分析强调从熟悉数据、编码、生成主题到审查和命名主题的迭代过程;近年的LLM研究也显示AI能辅助编码,但会出现主题边界模糊、过度碎片化和遗漏潜在含义等问题。[1][2]
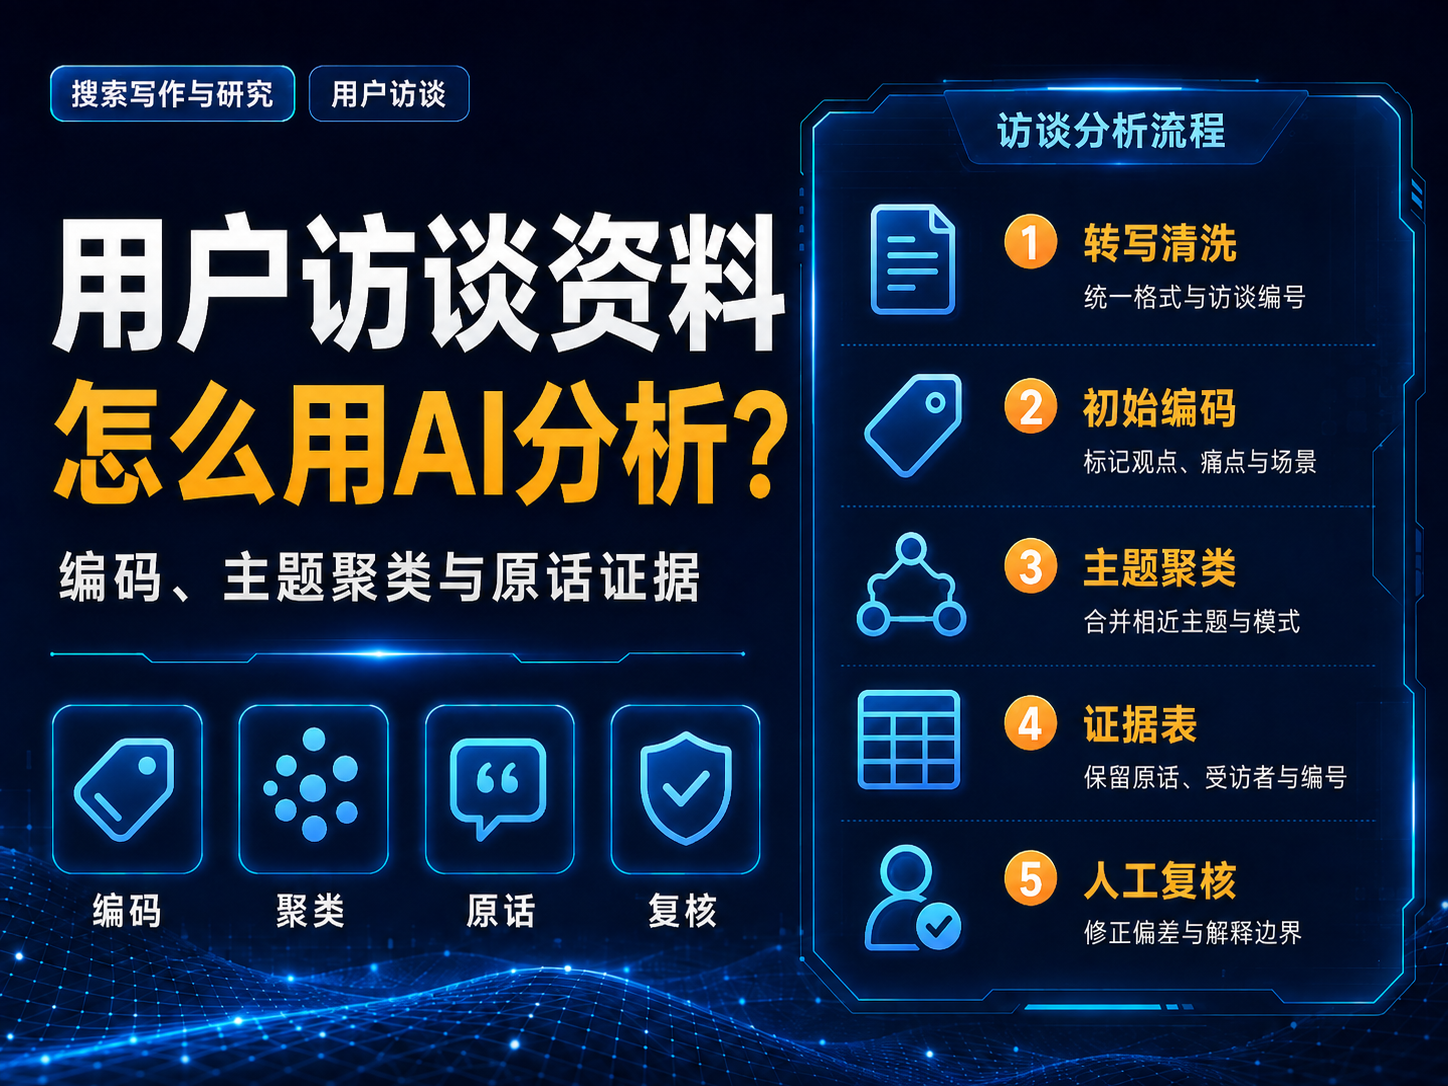
先把访谈资料整理成可追溯格式
每段文字至少要有访谈ID、说话人、时间戳、问题编号和原话。不要在AI清洗阶段就把口头重复、停顿和情绪信息全部删掉,因为它们有时是解释语境的一部分。
第一轮:熟悉数据,不急着做主题
先让AI按每份访谈生成“事实摘要”和“关键原话索引”,研究者再快速通读原文。目标是知道每个人说了什么,而不是立刻得到5个漂亮主题。
第二轮:做初始编码
编码应尽量贴近原话。建议输出:code_id、code_name、definition、quote、interview_id、context、researcher_note。AI可以给出候选编码,但研究者要合并同义编码、删除过度解释的编码。
第三轮:聚类成主题
| 层级 | 示例 |
|---|---|
| 原话 | “每次导出都要重新改格式,很浪费时间。” |
| 初始编码 | 重复格式调整 |
| 主题候选 | 工作流摩擦 |
| 解释 | 工具之间缺少格式一致性导致额外返工 |
主题不是“出现次数最多的词”。它应该能回答研究问题,并由多个证据片段支持。Braun与Clarke把主题分析描述为一种灵活但需要解释判断的方法。[1]
第四轮:建立“主题—证据”双向表
每个主题都保存:定义、包含哪些编码、支持它的访谈ID、代表性原话、反例、研究者解释。这样任何结论都能回到原始访谈,而不是停在AI生成的概括上。
第五轮:主动找反例
让AI专门找“与当前主题相反或不符合的原话”。如果一个主题只在2位重度用户中出现,就不要写成“用户普遍认为”。近期的人机协作主题分析研究也把人工解释权、修改、删除和拒绝AI输出视为关键环节。[3]
隐私处理
- 上传前移除不必要的姓名、电话、公司秘密;
- 记录工具和数据处理范围;
- 如果访谈同意书未覆盖第三方AI处理,应先确认研究和合规要求;
- 报告时避免用可识别的长原话暴露受访者。
文章局限
- 主题分析不是唯一的定性研究方法,不同方法的编码逻辑不同。
- AI生成的编码可能受提示词和模型偏差影响。
- 样本偏差不能靠AI“补齐”,结论范围必须服从研究设计。
参考来源
- Braun & Clarke:Using thematic analysis in psychology(核验于 2026-08-08)
- Martinez Montes等:LLMs in Thematic Analysis(核验于 2026-08-08)
- Human-AI Collaborative Inductive Thematic Analysis(核验于 2026-08-08)
更新记录
- 2026-08-08:首次整理并核验官方或一手资料,建立可复用流程与检查清单。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


 百度热点