直接回答:从公开网页提取结构化数据,优先级应该是:官方API/下载文件 > 页面内JSON-LD或其他结构化数据 > 稳定HTML元素 > 视觉/OCR。采集前要检查robots.txt、网站条款、登录和访问控制、速率限制、个人数据与版权;采集后要保留原始URL、抓取时间和字段来源。RFC 9309明确指出robots规则是给爬虫的访问约定,并不等同于访问授权。[1]
本文是技术与流程指南,不构成法律意见。不同国家、网站、数据类型和使用目的可能适用不同规则。
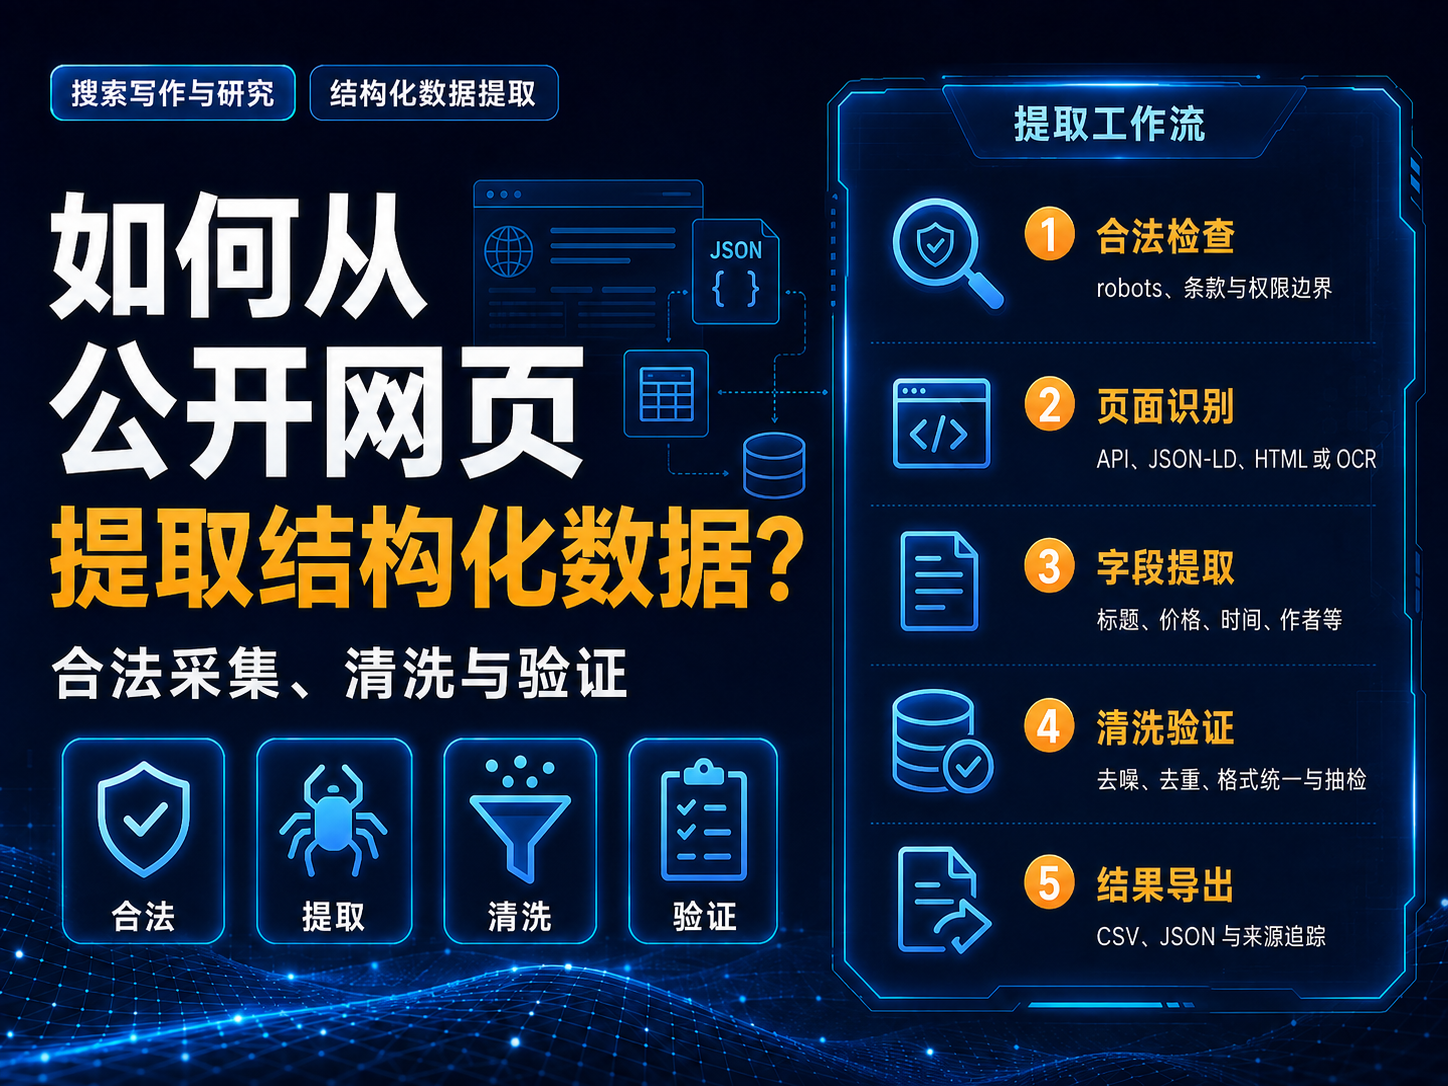
第一步:先找“结构化入口”
- 查看网站是否提供API、CSV、RSS或公开下载;
- 检查页面源码中的JSON-LD、Microdata或RDFa;
- 再考虑CSS选择器/XPath解析HTML;
- 只有数据写在图片或Canvas里时,才考虑OCR/视觉识别。
Google的结构化数据指南说明常见网页结构化标记包括JSON-LD、Microdata和RDFa。[2] 对采集者来说,页面已经提供的结构化字段通常比“看着页面猜字段”稳定得多。
第二步:采集前做五项检查
| 检查项 | 要确认什么 |
|---|---|
| robots.txt | 站点对自动爬取给了什么指示 |
| 服务条款 | 是否限制自动采集、再利用或商业使用 |
| 访问控制 | 是否需要账号、付费、验证码或绕过限制 |
| 个人数据 | 是否包含姓名、联系方式、敏感信息 |
| 频率 | 是否会造成过高请求或影响服务 |
robots.txt本身不是授权书:允许抓取不代表你自动拥有复制、再分发或商业利用的权利;禁止抓取也不应通过技术手段绕过。
第三步:先定义Schema,再抓数据
不要先抓一堆HTML再想怎么用。先写字段表:字段名、类型、是否必填、来源位置、单位、允许空值、唯一键和校验规则。
示例:product_name:string|price:number|currency:string|source_url:url|captured_at:datetime|source_selector:text|confidence:number。
第四步:清洗时保留“原始值”
推荐同时保存raw_value和normalized_value。例如页面写“$1,299/mo”,原始值保持不动,标准字段再拆成1299、USD、month。这样将来规则变化时可以重新处理,而不是失去原证据。
第五步:验证不能只看“有没有值”
- 抽样回到网页人工核对;
- 检查价格单位、日期格式、百分号和币种;
- 唯一键去重;
- 对异常值设置规则;
- 不同页面模板分别测试;
- 页面更新时记录解析失败率。
动态页面怎么办
如果数据来自接口请求,优先确认该接口是否公开并允许使用;不要绕过认证、验证码或访问控制。对需要浏览器执行JavaScript的公开页面,也应控制请求频率并记录抓取版本。
文章局限
- 技术上可访问不等于法律上可无限使用。
- 不同站点的条款、授权和数据类别不同。
- 网页结构会变化,生产采集必须监控解析失败与字段漂移。
参考来源
- IETF RFC 9309:Robots Exclusion Protocol(核验于 2026-08-08)
- Google Search Central:Structured Data Guidelines(核验于 2026-08-08)
更新记录
- 2026-08-08:首次整理并核验官方或一手资料,建立可复用流程与检查清单。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


 百度热点