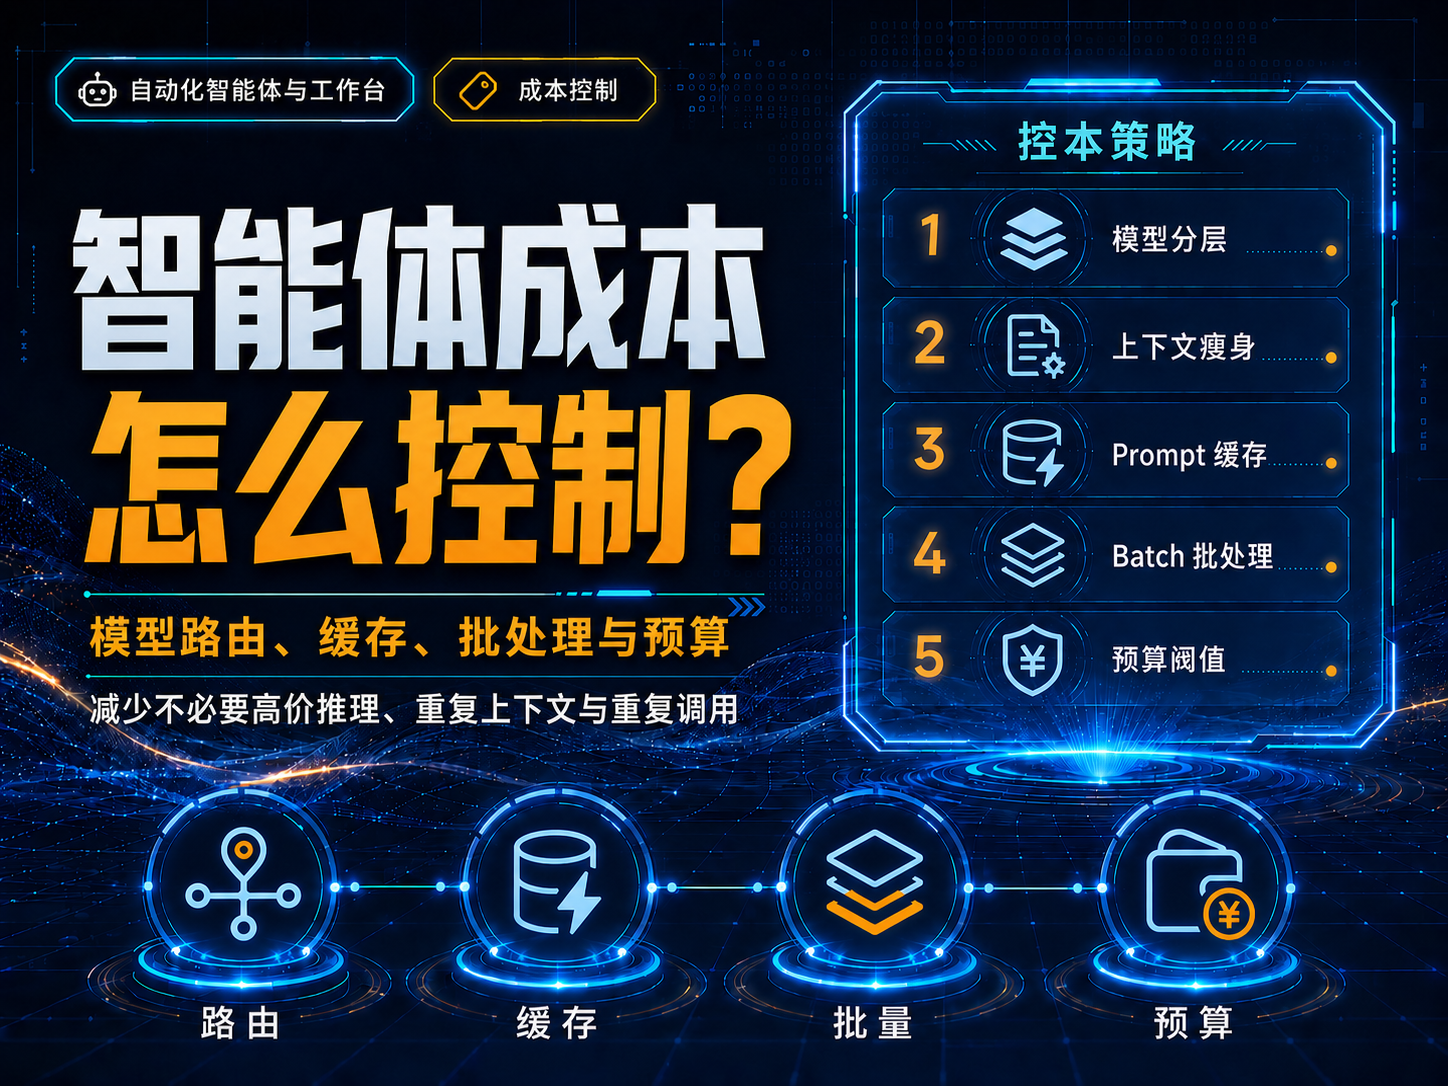
智能体成本怎么控制?模型路由、缓存、批处理与预算
先按任务难度分层
分类、抽取、格式化等稳定任务优先测试成本更低的模型;复杂规划、长链推理和最终审阅再升级到更强模型。是否降级要通过真实任务评测,而不是凭模型名称判断。
上下文是隐藏成本大户
不要每轮重复发送完整聊天、整库文档和所有工具说明。只保留当前任务需要的信息,对长会话做结构化摘要,并记录缓存命中与未命中。
异步任务适合批处理
夜间分类、离线评测、批量摘要等不要求即时返回的工作,可以使用批处理能力,把实时链路留给真正交互式任务。具体折扣和限制应以当前官方计费页为准。
给Agent设置“预算护栏”
| 护栏 | 作用 |
|---|---|
| 最大模型轮次 | 防止无意义循环 |
| 最大工具调用次数 | 防止反复搜索/抓取 |
| 最大Token/金额 | 超限降级或停下 |
| 最大重试次数 | 失败转人工 |
按业务结果计算成本
不要只看“每百万Token价格”。更有用的是每个完成任务的总成本,包括失败重试、搜索/工具费、缓存写入、存储和人工修正时间。
注意:模型和API价格变化较快;文章不固定写死“最便宜”结论,正式部署前应重新核对当前价格和模型能力。
资料核验日期:2026-08-09。产品功能、API、套餐、搜索规则与地区可用性会变化,正式使用前请再次查看官方页面。
参考来源
- OpenAI Developers:Models(official/primary,核验于 2026-08-09)
- OpenAI Developers:Model guidance(official/primary,核验于 2026-08-09)
- OpenAI API Reference:Batch(official/primary,核验于 2026-08-09)
更新记录
- 2026-08-09:完成官方/一手来源核验、结构化撰写与发布边界检查。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章



 百度热点