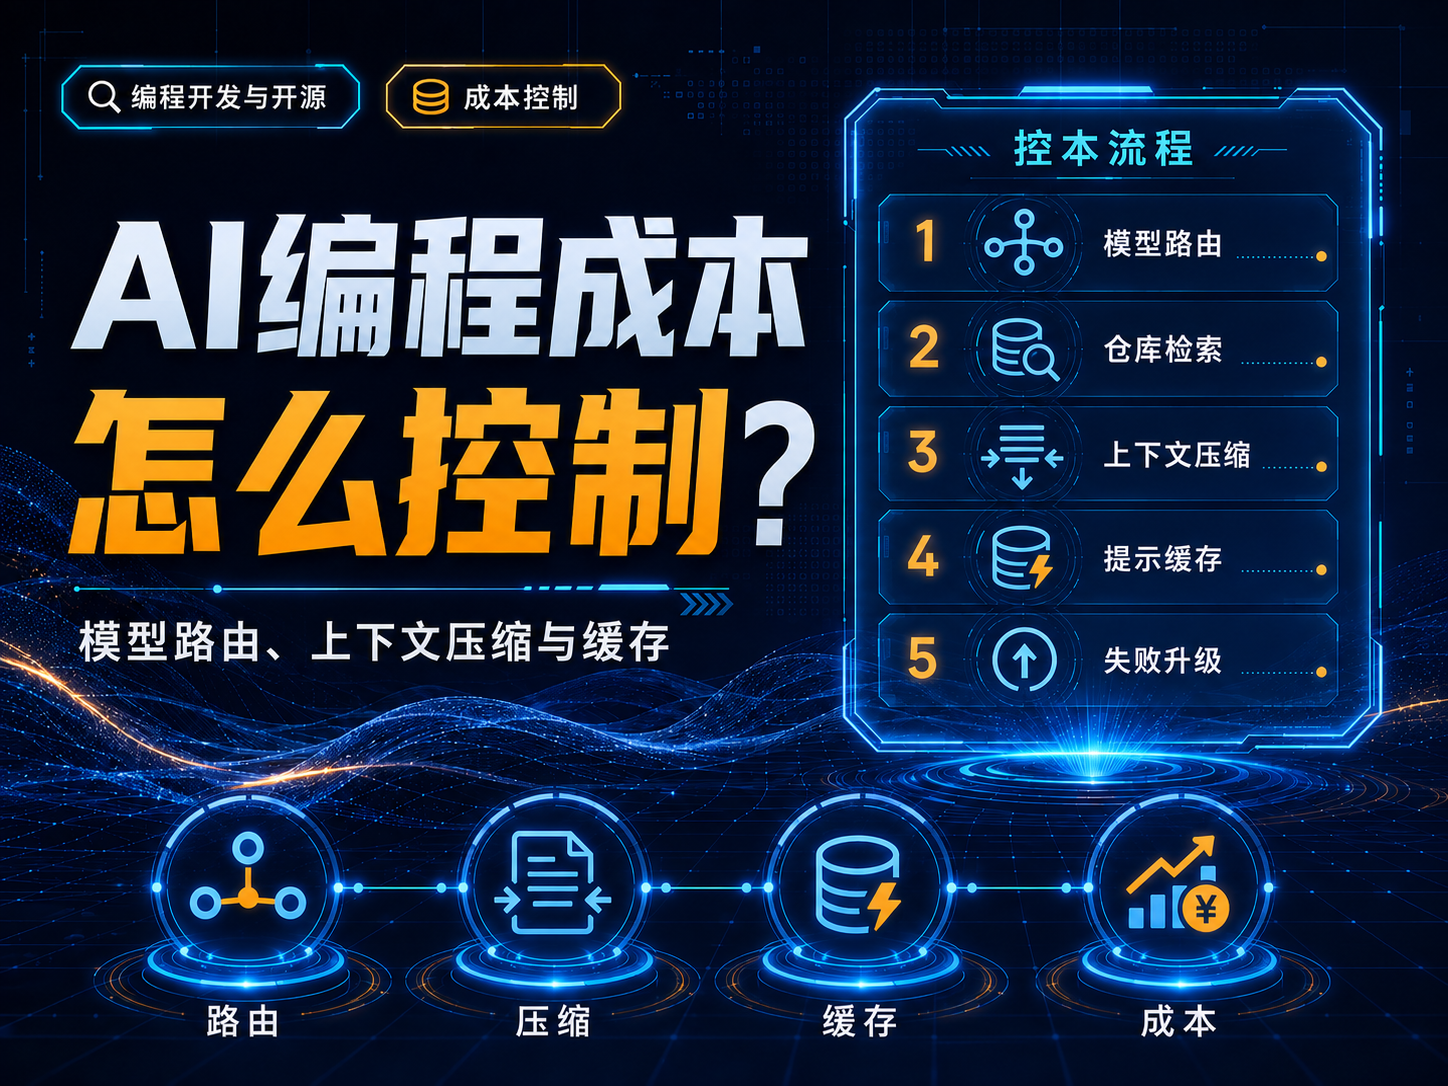
直接回答:AI编程降本最有效的办法通常不是只找“最便宜模型”,而是让合适的模型处理合适的任务,并减少重复上下文与失败重试。按“完成一个真实Issue需要多少钱”来管理成本,比只盯Token单价更有意义。[1][2]
先算账:成本由哪些部分组成
AI编程成本不仅是“每百万Token多少钱”,还包括重复上下文、输出长度、失败重试、工具调用、长上下文溢价和人工等待。最有价值的优化通常是减少不必要上下文和把简单任务路由到更便宜的模型。
模型路由:按风险和任务难度分层
- 格式化、简单解释、短补全:小/快模型。
- 常规Bug和单文件修改:主力模型。
- 跨文件、架构、安全、高风险迁移:强推理模型。
- 失败两次后升级模型,而不是无限重试。
上下文压缩不是删得越短越好
保留Issue、关键文件、接口、测试、错误和约束;删除重复日志、无关生成文件和整仓噪声。先让工具检索命中的文件,再把相关片段送给模型,通常比持续塞入整个仓库更省。
缓存适合“长前缀重复使用”
OpenAI当前模型指导提供显式prompt caching能力;Anthropic也明确把prompt caching用于重复的大型系统提示、文档或对话历史,以降低重复处理成本和延迟。[1][2]
| 策略 | 适合 | 指标 |
|---|---|---|
| 路由 | 任务难度差异大 | 高价模型调用占比 |
| 检索上下文 | 大型仓库 | 输入Token/任务 |
| 摘要压缩 | 长Agent会话 | 压缩后成功率 |
| 缓存 | 重复系统提示/文档 | cache hit比例 |
| 失败升级 | 小模型偶尔失败 | 重试次数与总成本 |
用“任务成本”而不是Token单价管理
最终记录:一个Issue从开始到测试通过的总模型费用、总耗时和人工干预。便宜模型如果反复失败,任务成本可能更高。
相关专题
如果你正在选择或比较不同的AI编程工具,可以查看此刻AI整理的完整专题:
AI编程工具推荐与对比:Claude Code、Cursor、Codex等怎么选 →
参考来源
- OpenAI API:Model guidance / prompt caching(核验于 2026-08-08)
- Claude Platform:Prompt caching(核验于 2026-08-08)
更新记录
- 2026-08-08:核验官方资料并完成全文结构化撰写。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


 百度热点