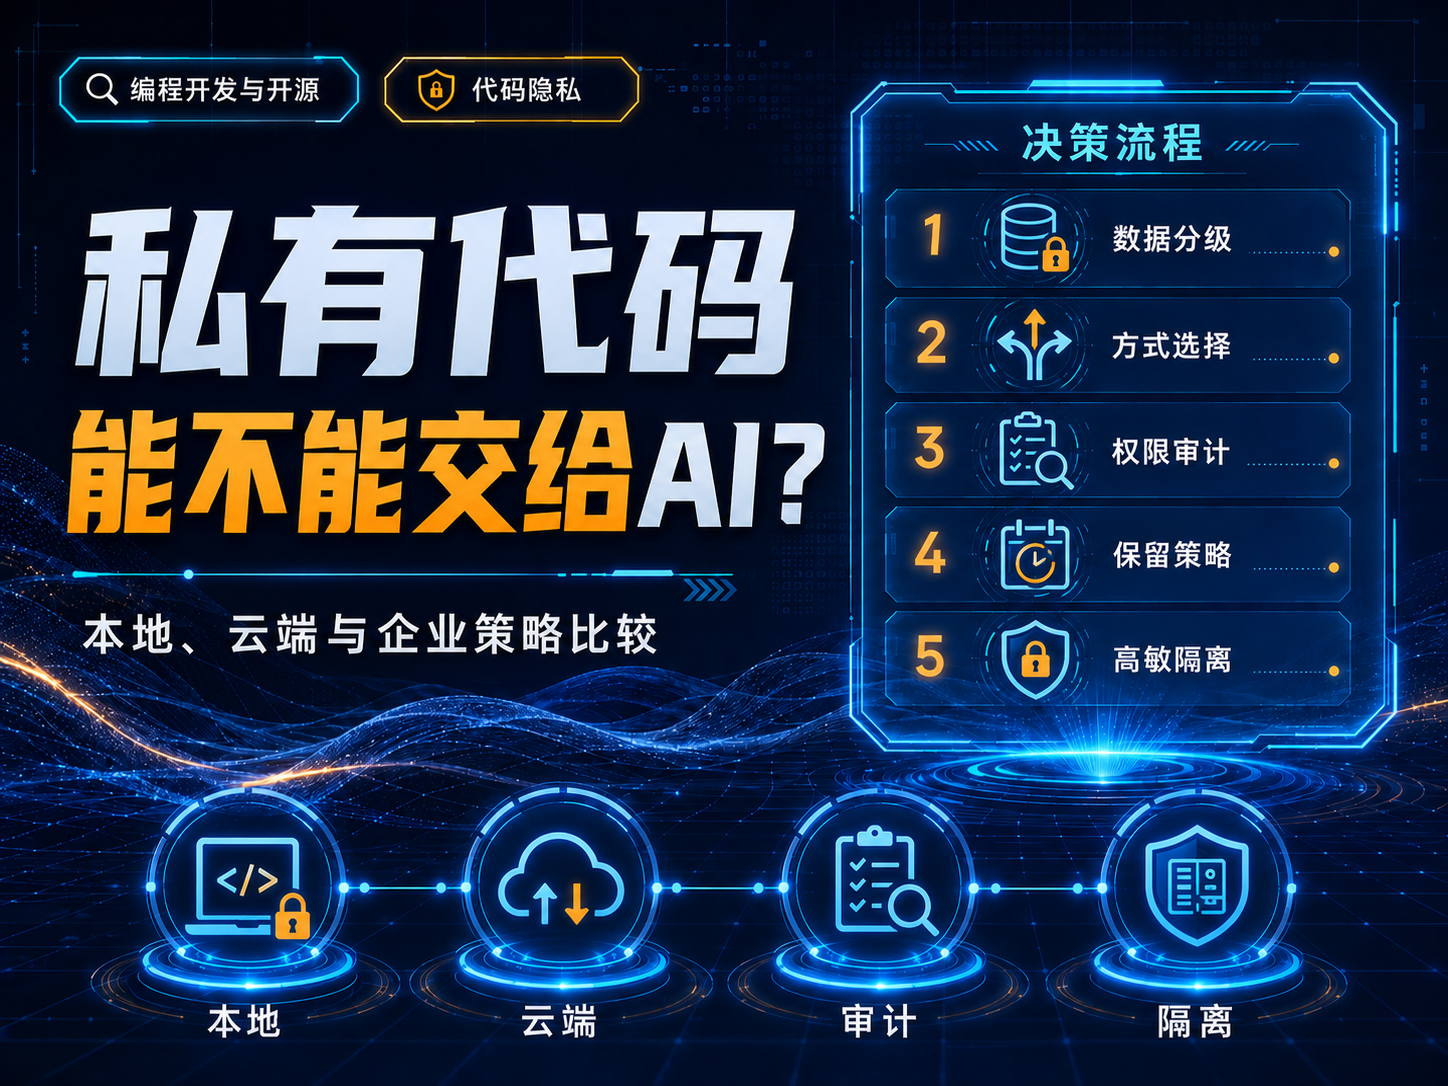
直接回答:可以,但必须先完成数据与权限评估。“某家AI安全”不是可执行结论;你需要核对实际计划的训练政策、保留、内容排除、工具权限、审计和合同。高敏代码应采用最小披露、本地/私有环境或企业级隔离策略。[1][2]
能不能交给AI,先看“数据边界”而不是品牌
要判断私有代码是否可以进入某个AI服务,至少确认:数据是否用于训练、保留多久、是否被人工查看、数据驻留、子处理商、日志、内容排除、管理员控制和合同条款。不同消费版、商业版、API计划可能完全不同。
三种部署/使用模式
| 模式 | 优势 | 代价/风险 |
|---|---|---|
| 本地模型/本地Agent | 代码不出自控环境 | 运维、模型能力、GPU成本 |
| 云API | 易集成、权限可控 | 需核对保留/地区/合同 |
| 企业AI产品 | 团队治理、SSO、策略和审计 | 订阅成本、功能边界 |
商业产品不能套用消费版数据政策
OpenAI官方商业数据页面说明,ChatGPT Business、Enterprise、Edu及API平台默认不使用输入或输出训练/改进模型。[1] 这类政策必须按你实际使用的产品计划核对,不能从个人账号经验推断企业账号。
内容排除也不是万能的
GitHub Copilot Business/Enterprise提供内容排除能力,但官方文档也明确部分Copilot形态并不支持内容排除,因此管理员需要按具体客户端和Agent模式确认覆盖范围。[2][3]
私有代码进入AI前的最小清单
- 删除/替换生产密钥和个人数据;
- 按仓库和目录分级;
- 高敏模块设置禁止上传规则;
- 限制Agent工具权限和网络访问;
- 启用审计日志;
- 明确生成代码的Review和许可证政策。
真正高敏时优先做隔离
涉及核心算法、受监管数据、客户源码或未公开安全信息时,优先考虑本地/私有部署、企业合同能力或严格的代码片段最小化,而不是把整个仓库默认暴露给任何助手。
参考来源
- OpenAI:Business data privacy, security, and compliance(核验于 2026-08-08)
- GitHub Docs:Content exclusion for Copilot(核验于 2026-08-08)
- GitHub Docs:Excluding content from Copilot(核验于 2026-08-08)
更新记录
- 2026-08-08:核验官方资料并完成全文结构化撰写。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


 百度热点