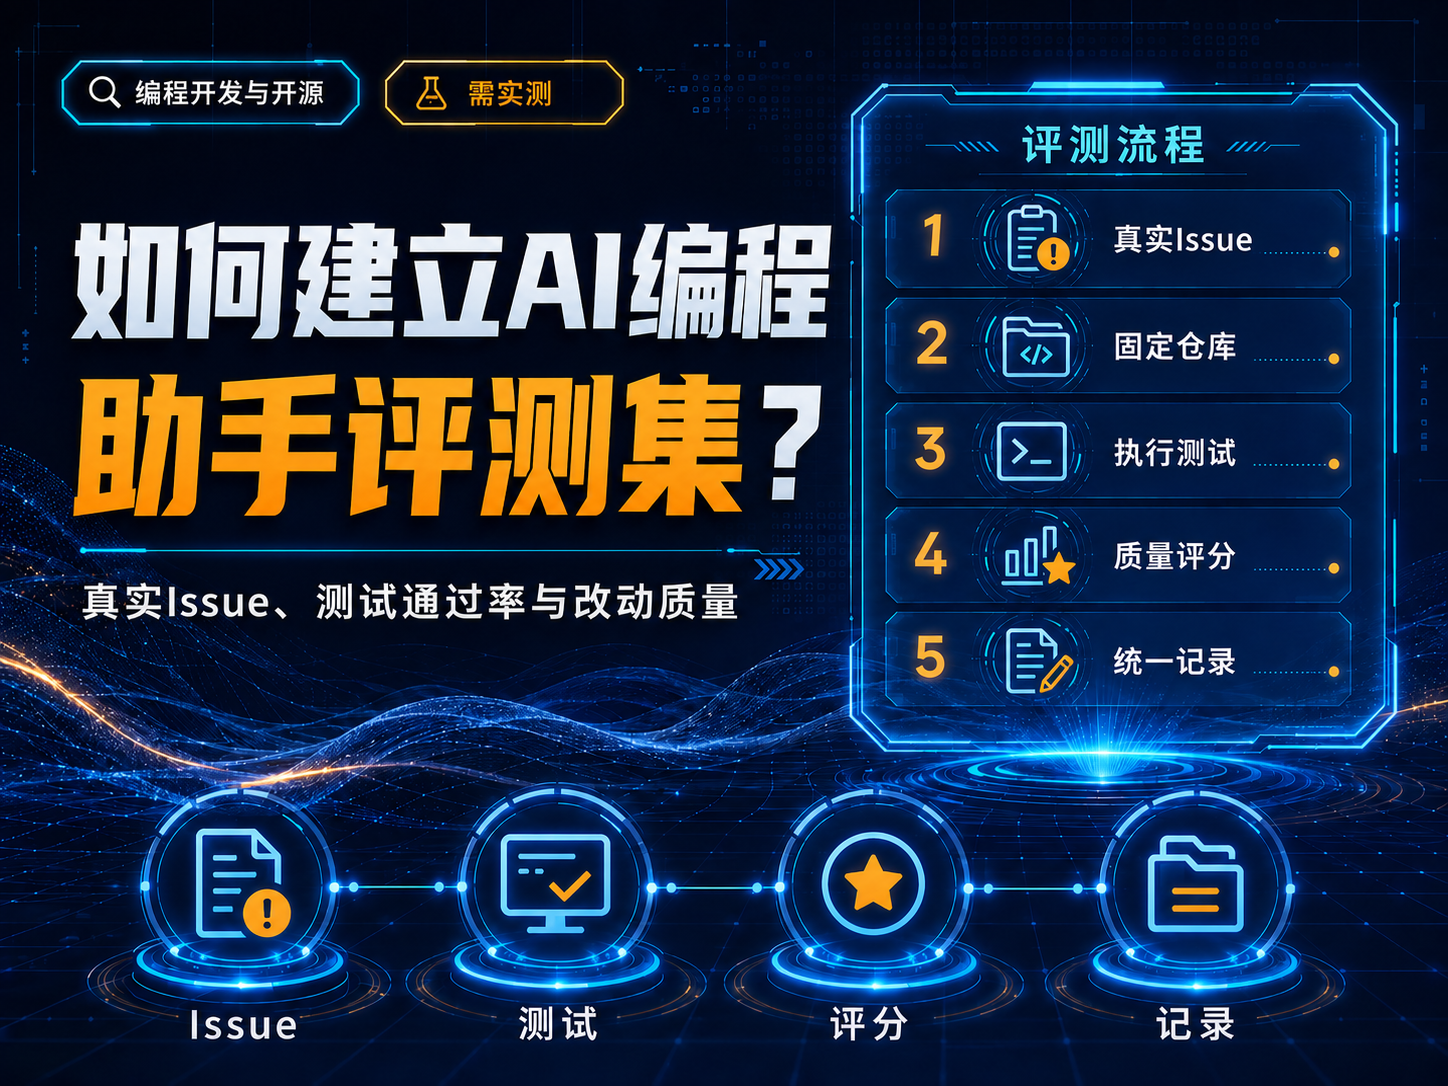
直接回答:高质量AI编程评测集的核心是真实Issue + 固定代码快照 + 可执行验收 + diff质量。测试通过只是第一层,还要检查回归、无关改动、人工干预、耗时和成本。SWE-bench就是以真实GitHub软件工程任务和测试验证作为重要基础。[1][2]
需实测:本文提供评测集设计方法;任何“某工具成功率最高”的结论都必须完成同一任务、环境、时间限制和版本下的真实测试。
评测集必须来自真实开发任务
SWE-bench用真实GitHub Issue、代码仓库和测试来评估模型是否能生成解决问题的patch,这种“任务+可执行验收”思路比只让模型写一道算法题更接近真实AI编程。[1][2]
每个样本至少包含
- 固定仓库commit;
- Issue/需求描述;
- 环境构建步骤;
- 失败测试或验收规则;
- 禁止修改范围;
- 完整测试命令;
- 人工质量评分项。
| 指标 | 含义 | 为什么需要 |
|---|---|---|
| 任务解决率 | 验收测试是否通过 | 最核心结果 |
| 回归率 | 旧测试是否被破坏 | 防止“修一处坏一片” |
| 改动质量 | 无关diff、复杂度、可读性 | 测试通过不等于好patch |
| 人工干预 | 提示/手改/重试次数 | 衡量真实生产力 |
| 时间/成本 | 到完成的总耗时与费用 | 比较效率而非单次响应 |
防止“测试投机”
模型可能删除测试、硬编码答案或绕开逻辑。评测环境应保护测试、检查diff,并增加隐藏/补充测试。SWE-bench的评估方式也是把生成patch应用到真实仓库后运行测试判断是否解决Issue。[2]
分层建设自己的数据集
建议先做20—50个高价值真实Issue,覆盖Bug、功能、小重构、测试、文档和配置;随后持续加入最新失败任务,避免评测集长期不更新导致过拟合。
统一实测规则
同一工具比较必须固定账号/版本、模型、仓库快照、时间限制、网络权限和测试硬件,并保存完整轨迹和最终patch。没有这些原始记录,不发布胜率排名。
相关专题
如果你正在选择或比较不同的AI编程工具,可以查看此刻AI整理的完整专题:
AI编程工具推荐与对比:Claude Code、Cursor、Codex等怎么选 →
参考来源
- SWE-bench 官方仓库(核验于 2026-08-08)
- SWE-bench Evaluation Guide(核验于 2026-08-08)
更新记录
- 2026-08-08:核验官方资料并完成全文结构化撰写。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章



 百度热点