直接回答:AI生成测试有用,但不能靠“测试通过”证明可靠。AI很适合补测试骨架、常见边界、参数化用例和Mock;真正的质量要看它是否验证业务行为、覆盖失败路径、避免过度Mock,以及当你故意注入一个真实缺陷时测试能不能失败。[1][2][3]
需实测:原始选题要求统一条件实测。本文提供可复现评测方法,不宣称任何AI工具“测试质量最高”。
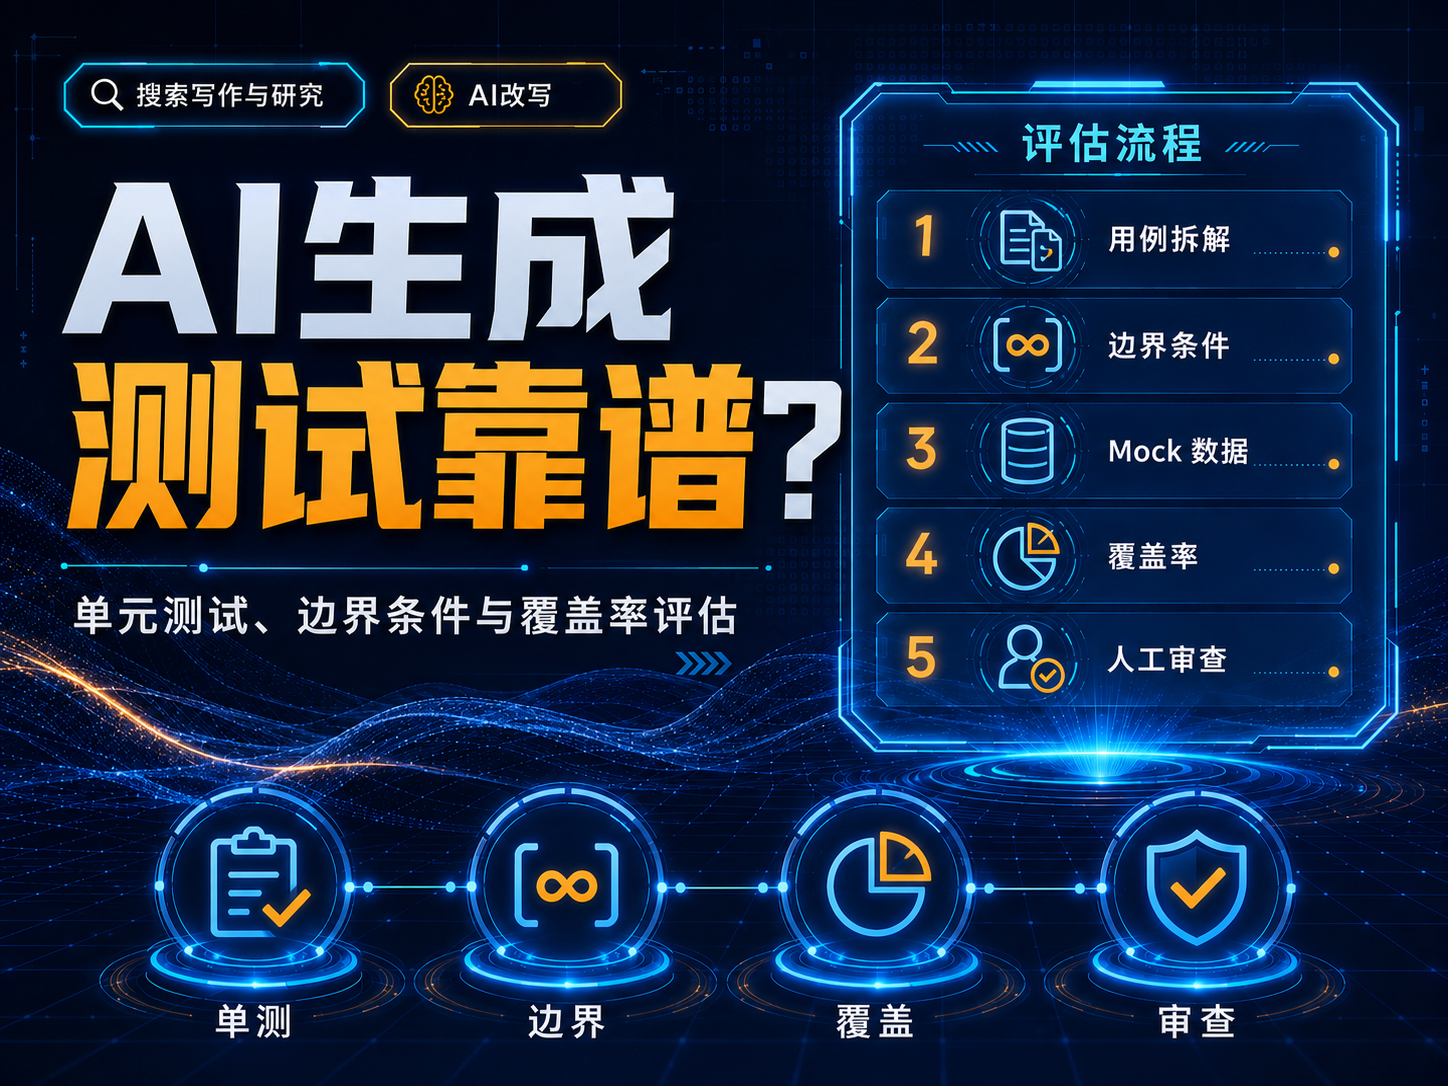
AI最适合生成哪些测试
- 纯函数的正常/异常输入;
- 参数化边界条件;
- 已有接口的回归用例;
- 重复性高的fixture和mock骨架;
- 根据明确验收条件生成E2E脚本初稿。
GitHub官方教程明确提供了用Copilot生成unit和integration tests的工作流,并强调生成后要实际运行验证。[1]
最危险的四种“假测试”
| 问题 | 表现 | 为什么危险 |
|---|---|---|
| 实现镜像 | 测试复制源码逻辑 | 源码错、测试一起错 |
| 过度Mock | 所有依赖都被替换 | 真实集成路径没被验证 |
| 只测Happy Path | 只验证正常输入 | 边界与错误处理仍未知 |
| 弱断言 | 只断言“不报错” | 错误结果也可能通过 |
用参数化测试扩大边界覆盖
pytest官方支持通过@pytest.mark.parametrize用多组输入运行同一测试。[2] 让AI先根据业务规则生成边界表,再把边界表转成参数化用例,比让它随意“多写几个测试”更可控。
Mock要隔离外部依赖,不要抹掉业务
Jest官方说明manual mock常用于把远程资源或外部模块替换成稳定假数据,从而减少慢和flaky测试。[3] 但数据库约束、事务、网络协议等如果正是被测目标,就不应该全部Mock掉。
一个真正有效的评测方法:故障注入
- 选10~30个真实函数/模块;
- 让AI根据相同说明生成测试;
- 先保证测试在正确代码上通过;
- 人工植入已知缺陷:边界+1、条件反转、漏权限、错误排序等;
- 统计测试能抓住多少缺陷;
- 记录误报、脆弱测试和维护成本。
单元、集成和E2E怎么分工
| 层级 | AI适合做什么 | 人工重点 |
|---|---|---|
| 单元 | 边界、参数化、异常 | 业务契约是否正确 |
| 集成 | 接口场景、fixture | 真实依赖与数据一致性 |
| E2E | 关键路径脚本初稿 | 选择真正关键用户流程 |
发布前检查
- 失败信息是否能定位问题;
- 测试是否独立可重复;
- 是否验证结果而非实现细节;
- 是否有边界和错误路径;
- 故意注入缺陷后能否失败。
参考来源
- GitHub Docs:Writing tests with GitHub Copilot(核验于 2026-08-08)
- pytest Docs:Parametrizing tests(核验于 2026-08-08)
- Jest Docs:Manual Mocks(核验于 2026-08-08)
- pytest Docs:Fixtures(核验于 2026-08-08)
更新记录
- 2026-08-08:核验AI生成测试、pytest参数化和Jest Mock官方资料;统一实测待补。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


 百度热点