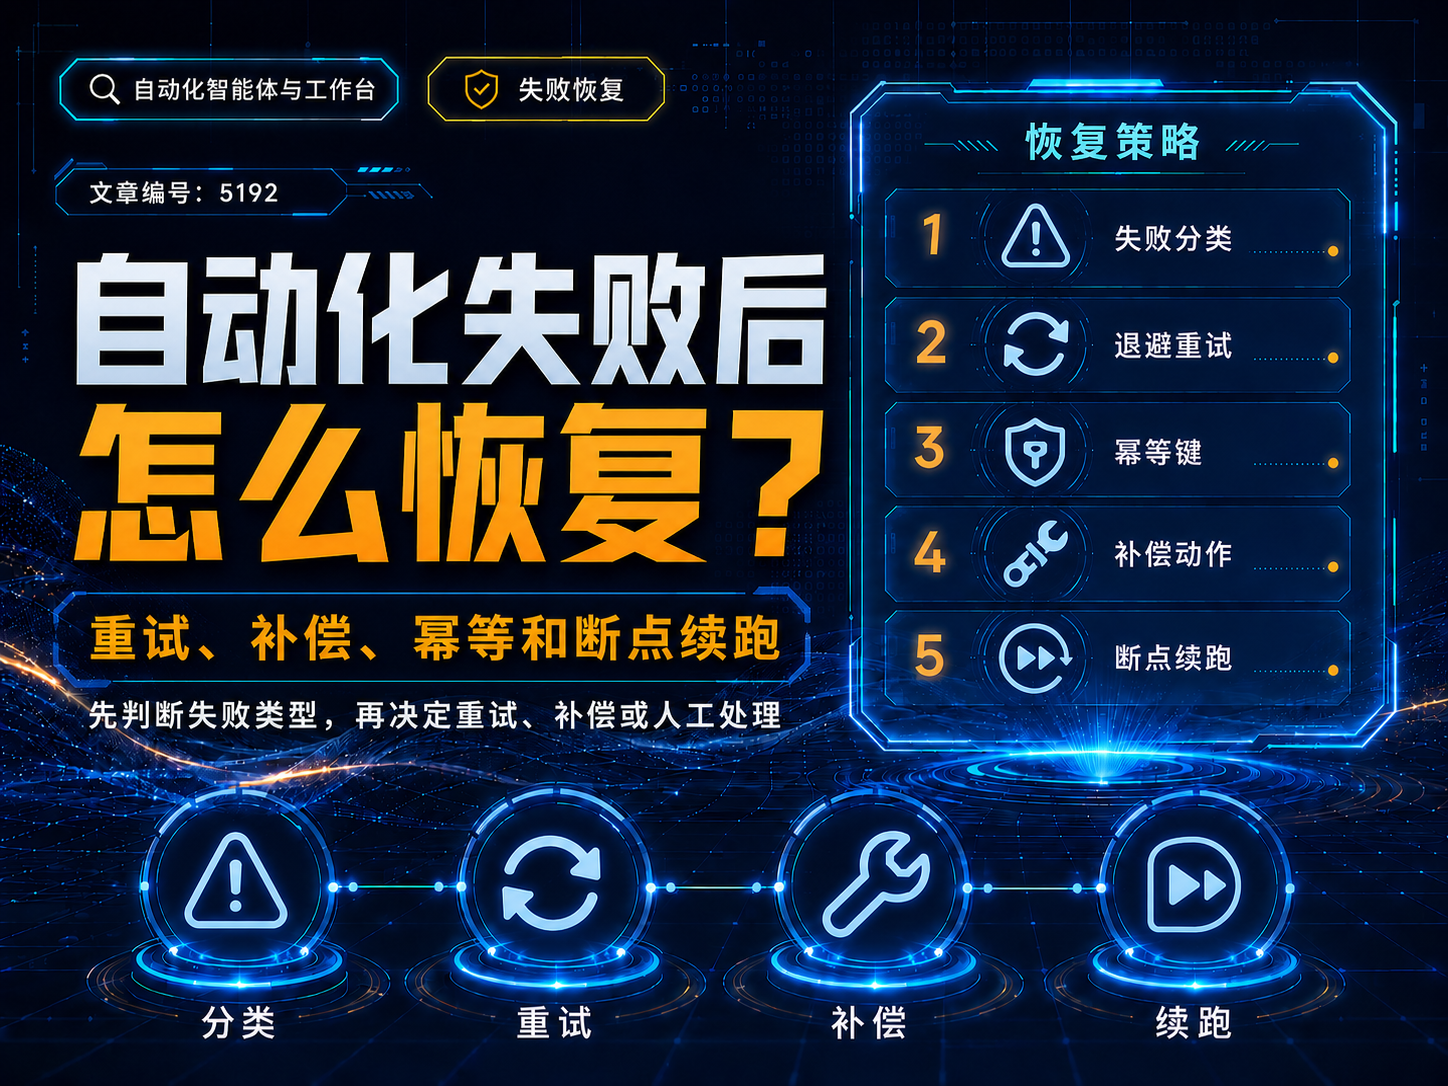
自动化失败后怎么恢复?重试、补偿、幂等和断点续跑
不是所有错误都应该重试
| 错误类型 | 处理 |
|---|---|
| 网络超时/429/临时5xx | 指数退避 + 抖动 + 上限 |
| 参数错误/权限不足 | 停止并修复配置 |
| 业务校验失败 | 转人工或返回上一步 |
| 重复请求风险 | 先检查幂等键/业务唯一键 |
幂等是安全重试的前提
“请求没收到响应”不代表动作没有成功。创建订单、扣款、发消息等动作重复执行可能造成严重副作用。给一次业务动作分配稳定的idempotency key或唯一业务键,让重复请求返回同一结果或被安全拒绝。
补偿不是数据库回滚的复制品
跨系统流程通常无法真正ACID回滚。已经发出的邮件无法“撤回成没发生”,此时补偿可能是发送更正、取消订单、恢复库存或创建人工处理任务。
长流程保存检查点
每个阶段完成后记录状态、输出引用、版本和外部对象ID。重启时从最近已确认检查点继续,而不是重新调用全部模型和外部API。
给死信和人工处理留入口
超过最大重试次数后进入失败队列,保留原始上下文和错误原因,允许人工修改参数后重放。不要无限重试造成成本和外部接口压力。
注意:对有副作用的操作,千万不要在没有幂等保护的情况下使用“无限自动重试”。
资料核验日期:2026-08-09。产品功能、API、套餐、搜索规则与地区可用性会变化,正式使用前请再次查看官方页面。
参考来源
- AWS Step Functions:Handling errors in workflows(official/primary,核验于 2026-08-09)
- Stripe API:Idempotent requests(official/primary,核验于 2026-08-09)
更新记录
- 2026-08-09:完成官方/一手来源核验、结构化撰写与发布边界检查。
如果你还想系统比较AI自动化平台、Agent工作流、自托管、错误恢复和安全设计,可以继续查看:AI自动化工具专题 →
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


 百度热点