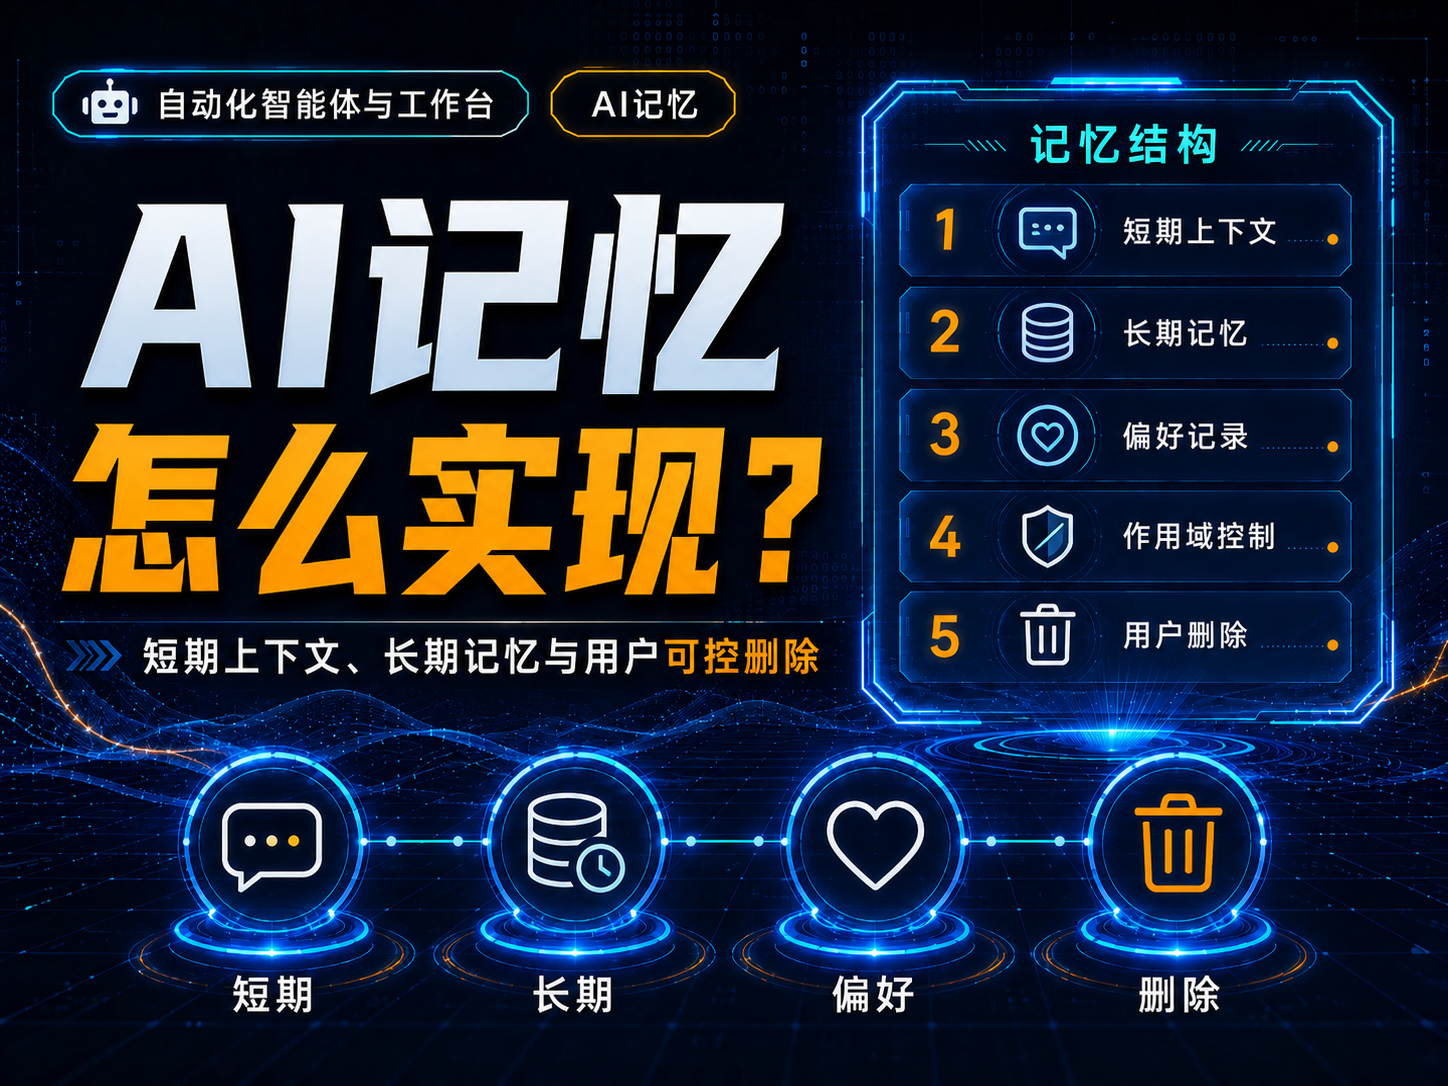
AI记忆怎么实现?短期上下文、长期记忆与用户可控删除
直接回答:AI记忆不应该是“把所有聊天永久存起来”。更可靠的实现是分成短期上下文、长期事实/偏好、任务状态、事件日志,每条记忆都有来源、时间、作用域和删除入口;模型只在需要时检索相关记忆。[1]
四类记忆不要混在一起
| 类型 | 保存内容 | 典型寿命 |
|---|---|---|
| 短期上下文 | 当前会话和当前任务中间状态 | 分钟到小时 |
| 用户偏好 | 语言、格式、常用习惯 | 长期,可编辑 |
| 事实记忆 | 用户明确确认的稳定事实 | 长期,有来源 |
| 任务/事件 | 项目状态、执行历史 | 按项目或保留策略 |
写入长期记忆要有门槛
不是每句话都值得记。建议满足至少一个条件:用户明确要求记住;信息会影响未来回答;信息稳定;来源可追踪。情绪性随口表达、敏感推断不应默认写入。
检索时按作用域收窄
先按用户、项目、时间和标签过滤,再做语义检索。避免“工作项目的记忆”跑到私人聊天里,也避免陈旧信息覆盖新状态。
冲突与过期怎么处理
同一事实出现新版本时,不是简单追加;应该更新current状态,同时保留变更历史。对临时任务设置TTL,到期自动失效。
用户必须能看见并删除
提供“查看我的记忆、编辑、删除、清空、关闭长期记忆”的控制面板。删除应真正影响后续检索,而不是只从UI隐藏。
注意:敏感信息(身份、财务、健康、密钥、私密通信等)不应因为“可能有用”就默认写入长期记忆。
资料核验日期:2026-08-09。产品功能、套餐、API、平台规则与地区可用性会变化,正式使用前请再次查看官方页面。
参考来源
- Anthropic:Trustworthy agents in practice(official,核验于 2026-08-09)
更新记录
- 2026-08-09:完成官方/一手来源核验、结构化撰写与发布边界检查。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章



 百度热点