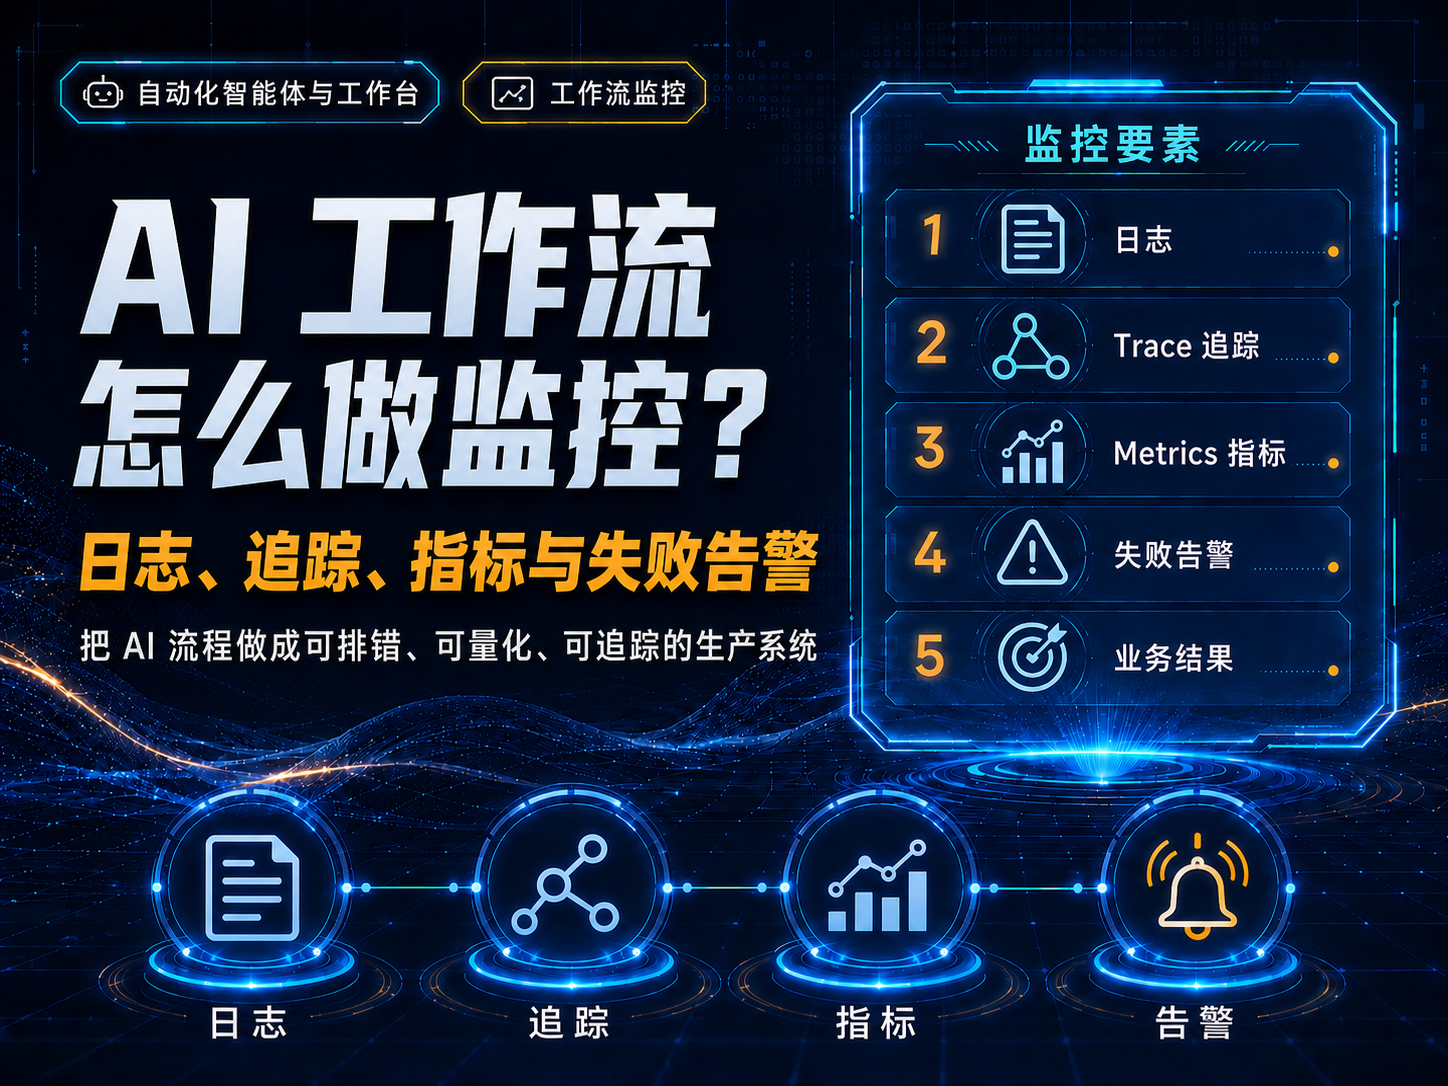
AI工作流怎么做监控?日志、追踪、指标与失败告警
直接回答:生产级AI工作流应同时有Logs、Traces、Metrics和Alerts:日志回答“发生了什么”,Trace回答“卡在哪一步”,指标回答“整体是否变差”,告警负责在需要人工介入时通知。[1][2]
先统一run_id和trace_id
一次用户请求可能经过模型、检索、数据库、工具、队列和外部API。每一步都带同一个run_id/trace_id,才能把零散日志拼成完整链路。
日志记录事实,不记录秘密
- 步骤名、状态、错误码、重试次数。
- 模型/提示词版本、工具名和参数摘要。
- 输入输出可存哈希或脱敏摘要。
- API Key、密码、身份证件等禁止落普通日志。
核心指标分四组
| 维度 | 建议指标 |
|---|---|
| 可靠性 | 成功率、失败率、重试率 |
| 性能 | P50/P95延迟、队列等待 |
| 成本 | Token、工具调用、单任务成本 |
| 质量 | 任务完成率、人工修改率、拒绝/回退率 |
告警必须指向可行动问题
不要对每个单次失败都报警。更实用的是:连续失败超过阈值、关键工具不可用、P95延迟突升、成本异常、某版本上线后质量指标恶化。
发布版本必须能关联监控
Prompt、模型、工具Schema或工作流改动都应带版本号。这样出现退化时可以快速定位“从哪个版本开始”。
注意:监控数据本身也可能包含用户隐私和商业数据,应设置脱敏、访问控制与保留周期。
资料核验日期:2026-08-09。产品功能、API、套餐、搜索规则与地区可用性会变化,正式使用前请再次查看官方页面。
参考来源
- OpenTelemetry:Documentation(official/primary,核验于 2026-08-09)
- OpenTelemetry:Semantic Conventions(official/primary,核验于 2026-08-09)
更新记录
- 2026-08-09:完成官方/一手来源核验、结构化撰写与发布边界检查。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


 百度热点