RAG是什么?为什么知识库有资料仍可能回答错误
直接回答:RAG(Retrieval-Augmented Generation)的核心是先检索相关资料,再让模型基于检索结果生成答案。知识库“明明有资料却答错”,通常不是一个原因,而是资料没被切对、没被召回、过滤错了、排序靠后、上下文塞太多,或模型没有正确使用证据。[1][2]
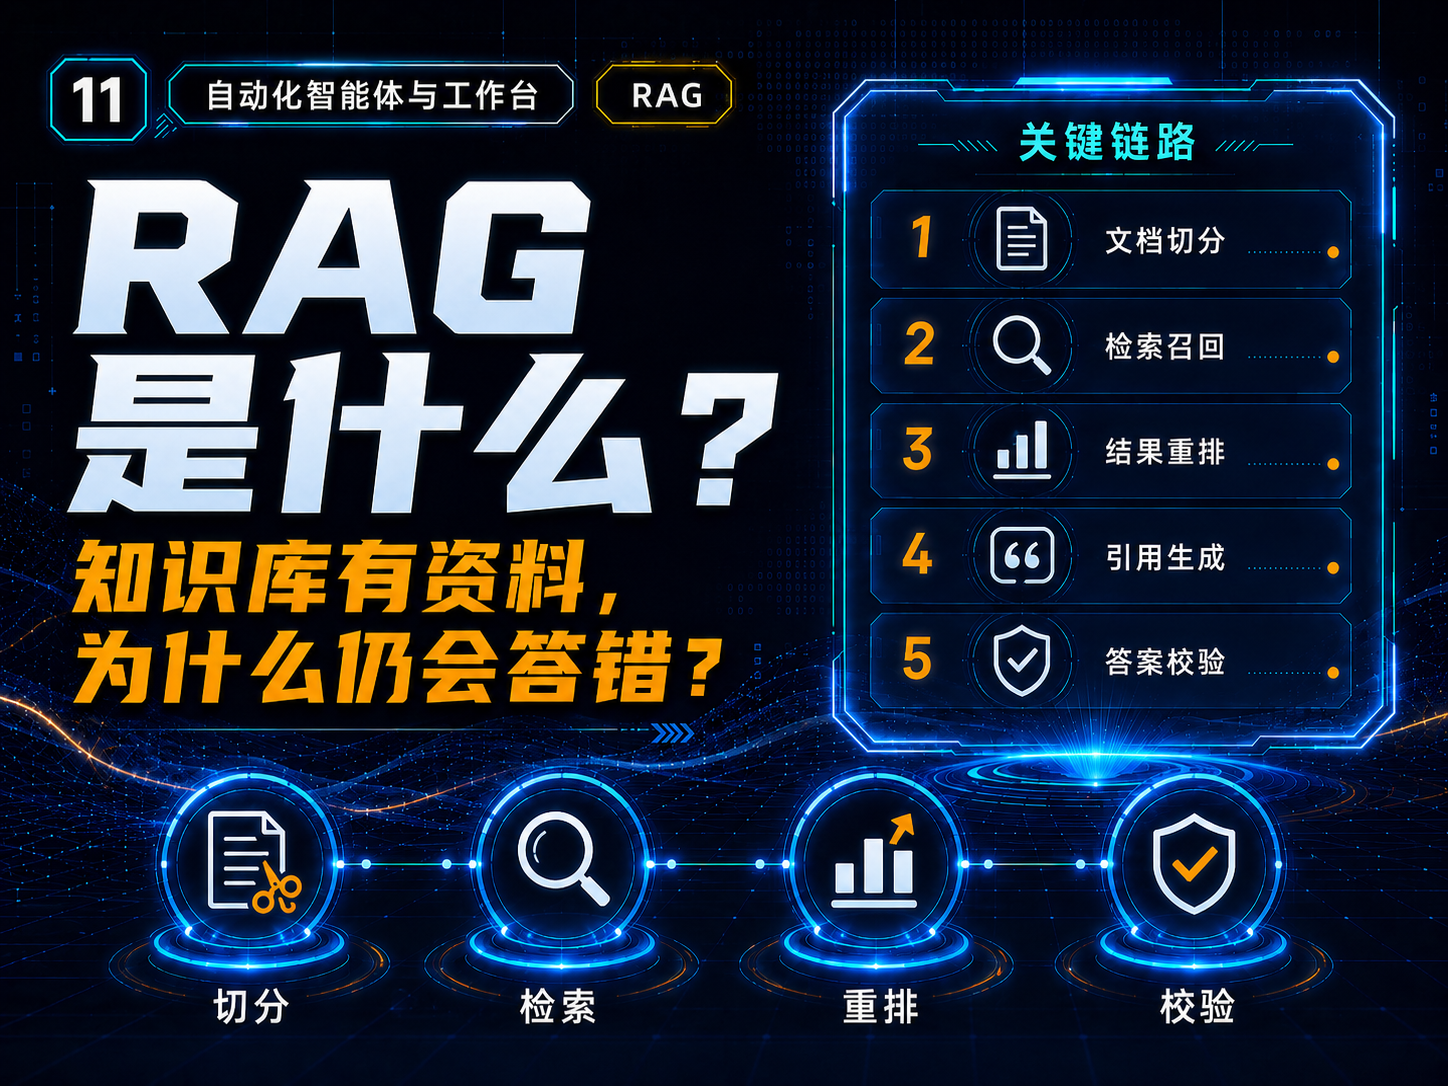
RAG链路里任何一环都可能丢信息
- 文档解析:PDF表格/图片可能没正确抽取。
- 切分:关键定义被拆到两个chunk。
- 索引:embedding无法表达精确ID或专有名词。
- 检索:query与原文词汇差异太大。
- 过滤:权限、时间、部门条件把正确文档过滤掉。
- 生成:检索到了,但模型仍忽略或误读证据。
为什么要混合检索
纯向量检索擅长语义相似,但对编号、产品型号、专名、错误码可能不稳定。Qdrant官方的Hybrid Search把dense语义检索与sparse/关键词检索结合,适合同时覆盖“意思相近”和“词必须精确”。
过滤和权限必须在检索阶段做
不要先全库召回再让模型“自己忽略无权数据”。部门、用户、项目、时间、版本等条件应作为metadata filter进入检索链。
给RAG做评测集
准备30—100个真实问题,每个问题标注正确来源文档。分别评估:有没有召回正确文档、正确文档排第几、最终答案是否引用正确。否则只看聊天体验,很难知道错在哪一层。
引用能显著提升可检查性
最终答案保留文档标题、段落/页码或URL,用户能快速回原文确认。无法找到证据时,系统应允许回答“资料不足”。
注意:RAG降低了“模型凭空回答”的概率,但不等于消除幻觉。检索结果和最终回答仍然需要分层评测。
资料核验日期:2026-08-09。产品功能、套餐、API、平台规则与地区可用性会变化,正式使用前请再次查看官方页面。
参考来源
- Qdrant:Hybrid and Multi-Stage Queries(official,核验于 2026-08-09)
- Qdrant:Filtering(official,核验于 2026-08-09)
更新记录
- 2026-08-09:完成官方/一手来源核验、结构化撰写与发布边界检查。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


 百度热点