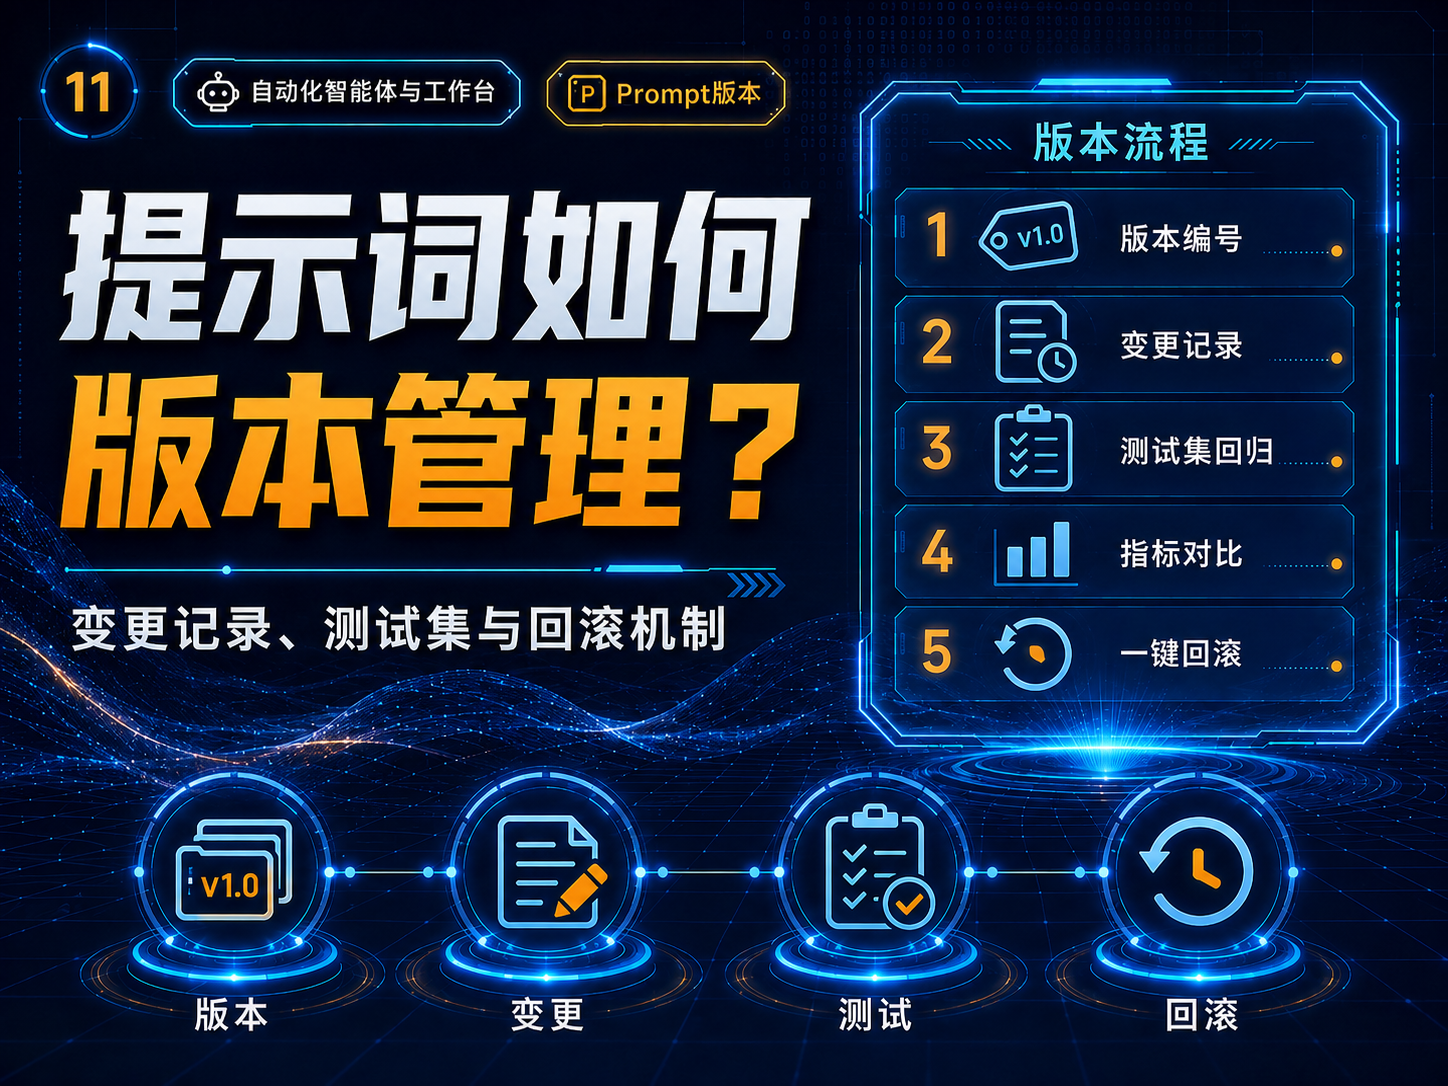
提示词如何版本管理?变更记录、测试集与回滚机制
一个版本至少保存这些字段
| 字段 | 示例/作用 |
|---|---|
| prompt_version | 如 support-v12 |
| model_config | 模型、推理参数、工具版本 |
| change_reason | 解决哪个失败样本 |
| eval_set | 固定测试集版本 |
| owner/date | 负责人和发布日期 |
测试集来自真实失败样本
不要只写“看起来很难”的示例。把生产中出现的错误、边界条件、格式失败和安全案例匿名化后加入回归集;同时保留常规样本,避免只修一个问题却破坏其他能力。
一次只改一类变量
如果同时换模型、Prompt、工具Schema和检索策略,就无法知道提升来自哪里。高价值流程至少在实验记录中区分这些变化。
发布用版本指针,不覆盖历史
生产环境引用active_prompt_version;新版本先跑离线Evals,再少量灰度。指标退化时把指针切回旧版本,而不是临时手改文本。
结果要保存失败样本
平均分无法解释回归原因。保存每个case的输入、输出、grader结果、错误类型和人工备注,才能持续扩充测试集。
注意:Prompt评测高度依赖具体任务和模型版本;本文不虚构任何“提升百分比”。
实测边界:这篇文章给出评测方法和记录模板,不声称任何模型、平台或方案已经获得“第一”“最好”或固定准确率。正式发布比较结论前,应保存同一测试集、同一输入、原始输出、参数、日期和失败样本。
资料核验日期:2026-08-09。产品功能、API、套餐、搜索规则与地区可用性会变化,正式使用前请再次查看官方页面。
参考来源
- OpenAI API Reference:Evals(official/primary,核验于 2026-08-09)
- OpenAI Developers:Model guidance(official/primary,核验于 2026-08-09)
更新记录
- 2026-08-09:完成官方/一手来源核验、结构化撰写与发布边界检查。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章



 百度热点