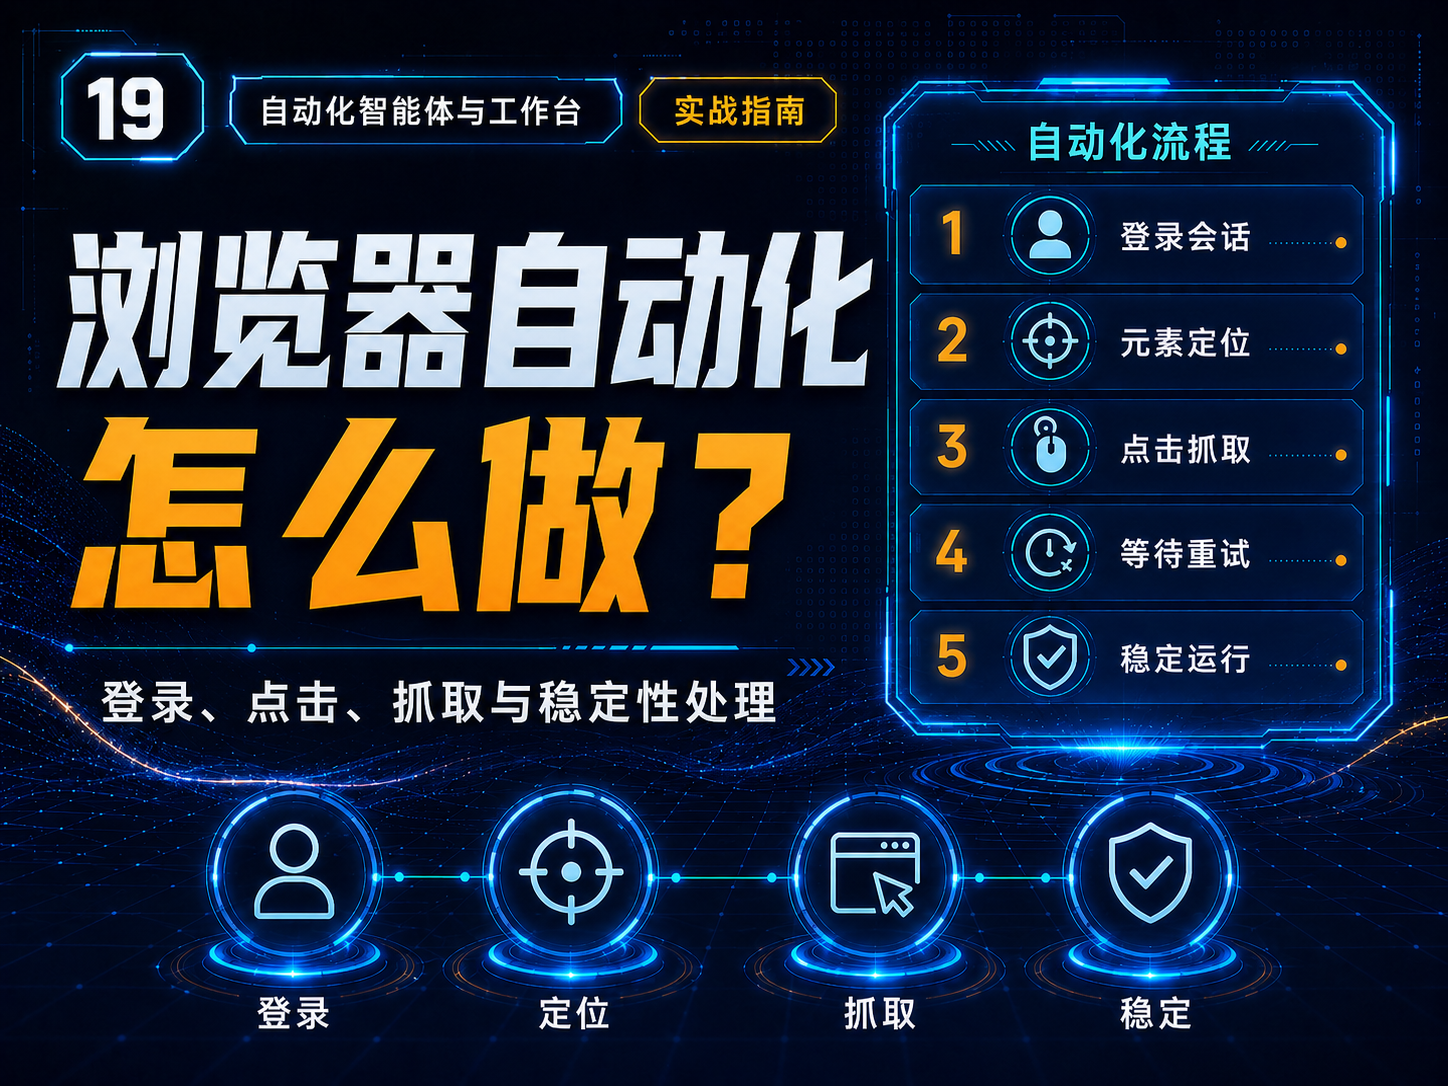
浏览器自动化怎么做?登录、点击、抓取与稳定性处理
直接回答:稳定的浏览器自动化不是“录一遍点击动作”,而是用可靠定位器、自动等待、可复用登录状态和明确失败证据来执行。Playwright官方把Locator作为自动等待与重试能力的核心,并建议优先使用role、label、text等面向用户语义的定位方式。[1][2][3]
第一步:登录状态单独管理
不要每条流程都从账号密码登录。可以先建立专门的认证流程,保存登录状态供后续任务复用,同时把认证状态文件当作敏感凭证,不提交到代码仓库。
第二步:少用脆弱CSS路径
- 优先getByRole、getByLabel、getByText。
- 必要时使用稳定data-testid。
- 尽量避免第几个div、动态class、绝对XPath。
- 页面改版后先检查定位器是否仍代表用户可见语义。
第三步:让工具等待“可操作”而不是固定sleep
Playwright在点击前会检查元素是否可见、稳定、能接收事件、可用。固定等待3秒既慢又不稳定;应等待目标状态或网络/页面条件。
第四步:抓取与点击要分层
读数据和写数据分开。先抓页面并验证结构,再执行点击/提交;写操作前保存截图、目标URL和关键参数,发生错误容易复盘。
第五步:为失败准备证据
失败时至少保存:截图、HTML片段、控制台错误、网络错误、当前URL和步骤编号。只有这样“自动重试”才不是盲目重复。
注意:自动化登录和抓取必须遵守目标网站条款、robots/访问限制和账号权限;不要把登录Cookie、Token或存储状态泄露到日志。
资料核验日期:2026-08-09。产品功能、套餐、API、平台规则与地区可用性会变化,正式使用前请再次查看官方页面。
参考来源
- Playwright:Locators(official,核验于 2026-08-09)
- Playwright:Auto-waiting(official,核验于 2026-08-09)
- Playwright:Authentication(official,核验于 2026-08-09)
更新记录
- 2026-08-09:完成官方/一手来源核验、结构化撰写与发布边界检查。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


 百度热点