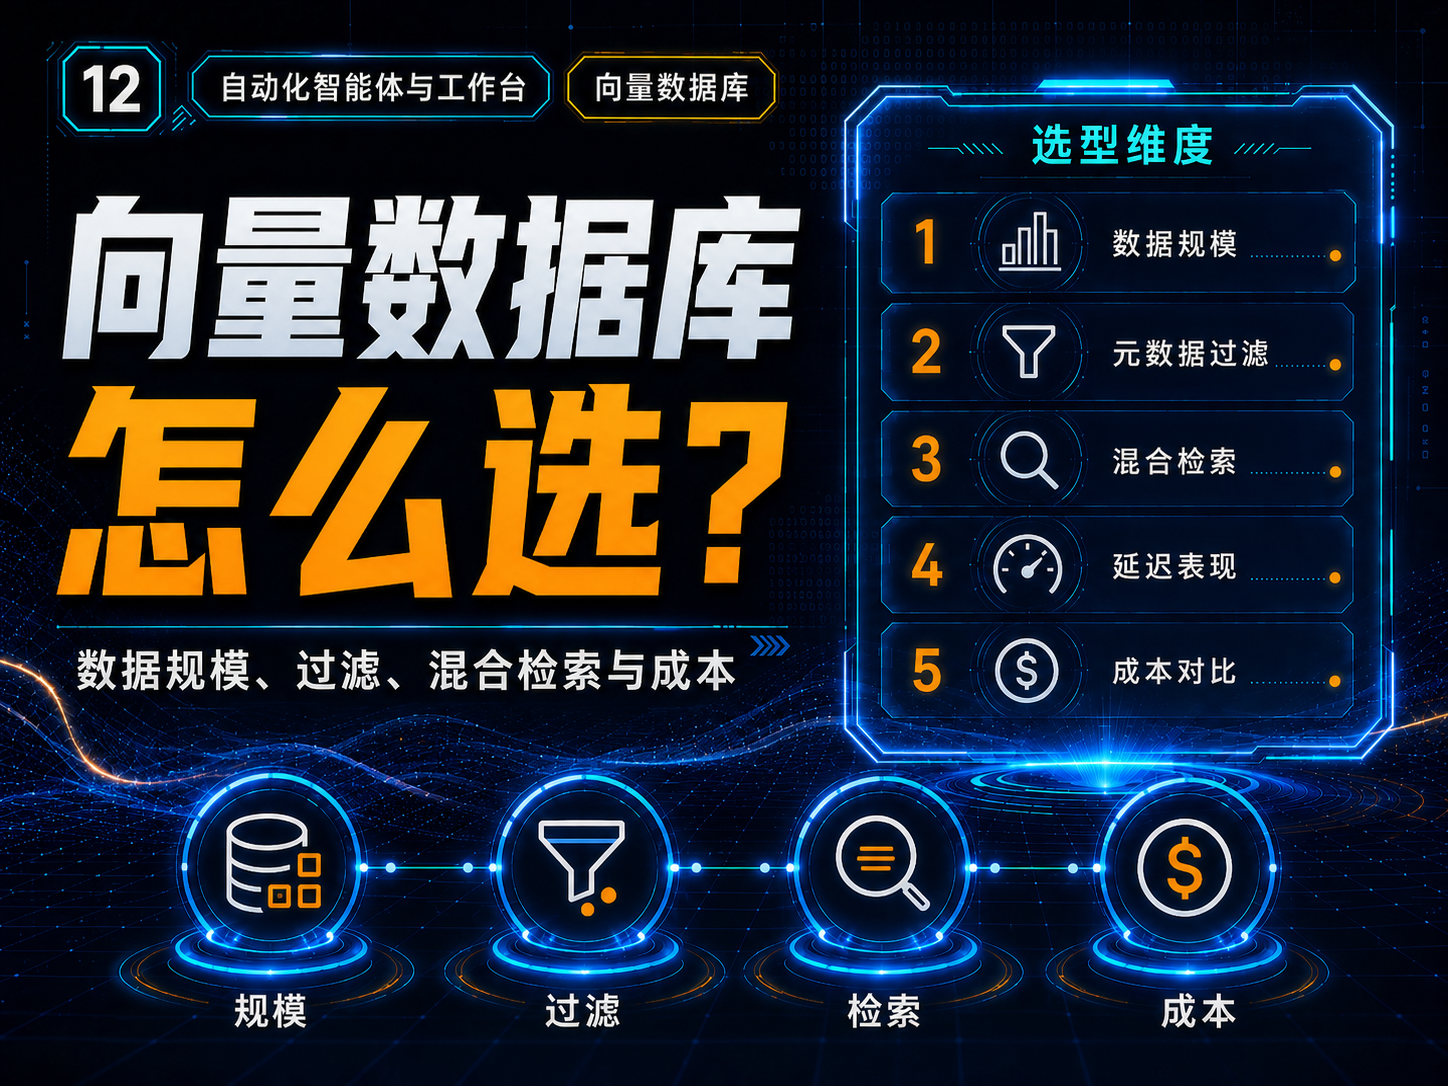
向量数据库怎么选?数据规模、过滤、混合检索与成本
直接回答:向量数据库选型没有通用第一名。真正影响体验的是数据规模、过滤条件、写入频率、混合检索、重排、延迟、部署方式和总成本。例如Qdrant官方同时提供payload filtering、dense+sparse hybrid query和multi-stage query,这些能力只有放到你的数据上实测才有意义。[1][2][3]
先写需求,不要先看品牌
先回答:有多少向量?维度多大?每天写多少?是否多租户?是否按用户/项目/时间过滤?需不需要BM25/稀疏检索?是否要本地部署?延迟目标多少?
过滤能力是RAG常见分水岭
企业知识库经常需要metadata filter。检查数据库是否支持布尔、日期、数字、嵌套字段和过滤索引;还要测试“高过滤选择性”下的延迟。
混合检索不要只看“有/没有”
比较dense+sparse如何融合、是否支持RRF/加权、是否能先召回再rerank。Qdrant的Query API支持多阶段和多路prefetch,但不同产品实现差异很大。
统一实测框架
| 指标 | 怎么测 |
|---|---|
| 召回质量 | 固定50—200个真实查询和相关文档 |
| 过滤延迟 | 不同filter选择性下P50/P95 |
| 写入能力 | 批量写入、更新、删除 |
| 稳定性 | 并发查询+持续写入 |
| 成本 | 存储+查询+备份+网络+运维 |
小规模项目不要过度工程
几万到几十万条数据时,单机/托管轻量方案往往已经够用;只有规模、并发、隔离或合规需求上来后,才值得投入复杂分布式架构。
注意:本篇不虚构跨产品性能排名。不同向量维度、索引参数、过滤条件和硬件会显著改变结果,正式选型必须用你的真实数据压测。
资料核验日期:2026-08-09。产品功能、套餐、API、平台规则与地区可用性会变化,正式使用前请再次查看官方页面。
参考来源
- Qdrant Documentation(official,核验于 2026-08-09)
- Qdrant:Filtering(official,核验于 2026-08-09)
- Qdrant:Hybrid and Multi-Stage Queries(official,核验于 2026-08-09)
更新记录
- 2026-08-09:完成官方/一手来源核验、结构化撰写与发布边界检查。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


 百度热点