Human-in-the-loop怎么设计?哪些操作必须人工确认
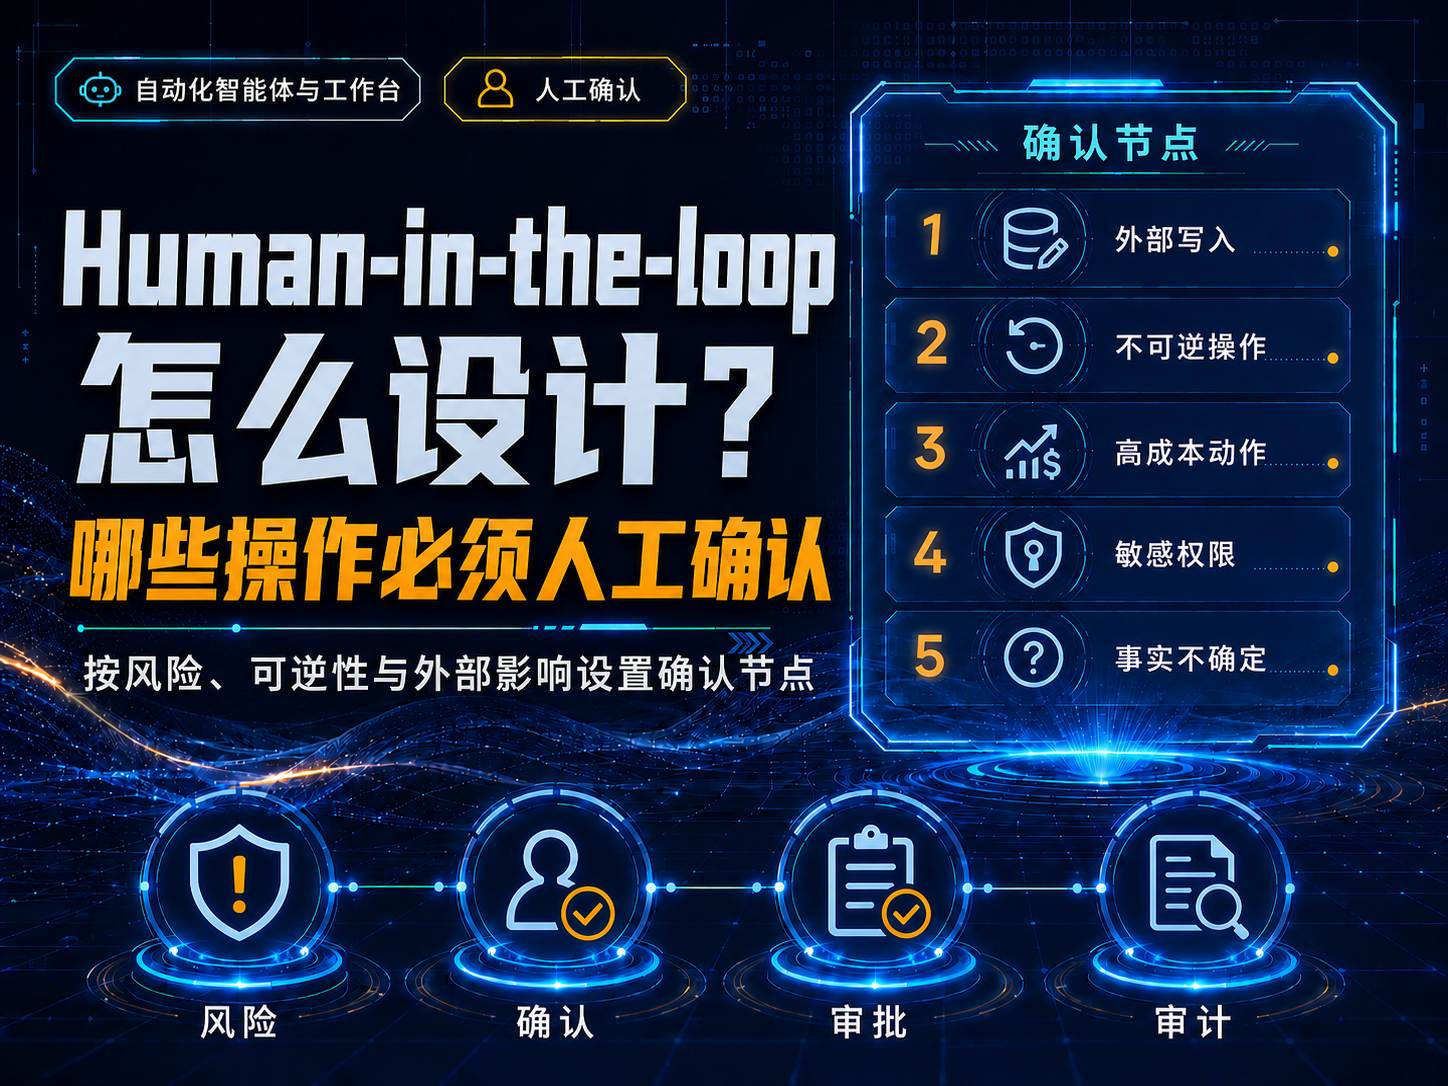
先把动作按风险分级
| 等级 | 动作类型 | 默认策略 |
|---|---|---|
| L0 只读 | 搜索、读取、总结、诊断 | 通常无需确认 |
| L1 可撤销内部写入 | 生成草稿、加内部标签 | 可自动或批量确认 |
| L2 外部写入 | 发邮件、建会议、发布内容 | 建议执行前确认 |
| L3 高风险 | 付款、删除、改权限、法律/财务承诺 | 必须显式确认 |
确认点应该放在哪里
确认点应放在动作执行之前,而不是模型已经发出请求之后。页面要展示“将执行什么、影响哪个对象、关键参数、能否撤销、预计成本”,让用户确认的是具体动作而不是抽象的“允许AI继续”。
不要把低风险步骤全部卡住
如果搜索、读取文件、分析日志、生成本地草稿都要逐步确认,工作流会被人为打断。更好的做法是明确安全本地动作白名单,让模型连续完成准备工作,只在跨越权限边界时停下。
给确认动作加审计信息
- 记录请求者、模型/工作流版本与时间。
- 保存执行前参数摘要和执行结果。
- 对高风险动作保留审批人和原因。
- 能撤销的操作要提供撤销入口。
拒绝、超时与修改也要设计
用户拒绝后应安全结束或回到草稿状态;审批超时不能默认放行;用户修改参数后应重新展示最终动作,避免“确认的是A,执行的是B”。
注意:人工确认不是安全措施的全部。后端仍需参数校验、最小权限、额度限制和审计日志。
资料核验日期:2026-08-09。产品功能、API、套餐、搜索规则与地区可用性会变化,正式使用前请再次查看官方页面。
参考来源
- OpenAI Developers:Model guidance(official/primary,核验于 2026-08-09)
- AWS IAM:Security best practices(official/primary,核验于 2026-08-09)
更新记录
- 2026-08-09:完成官方/一手来源核验、结构化撰写与发布边界检查。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


 百度热点