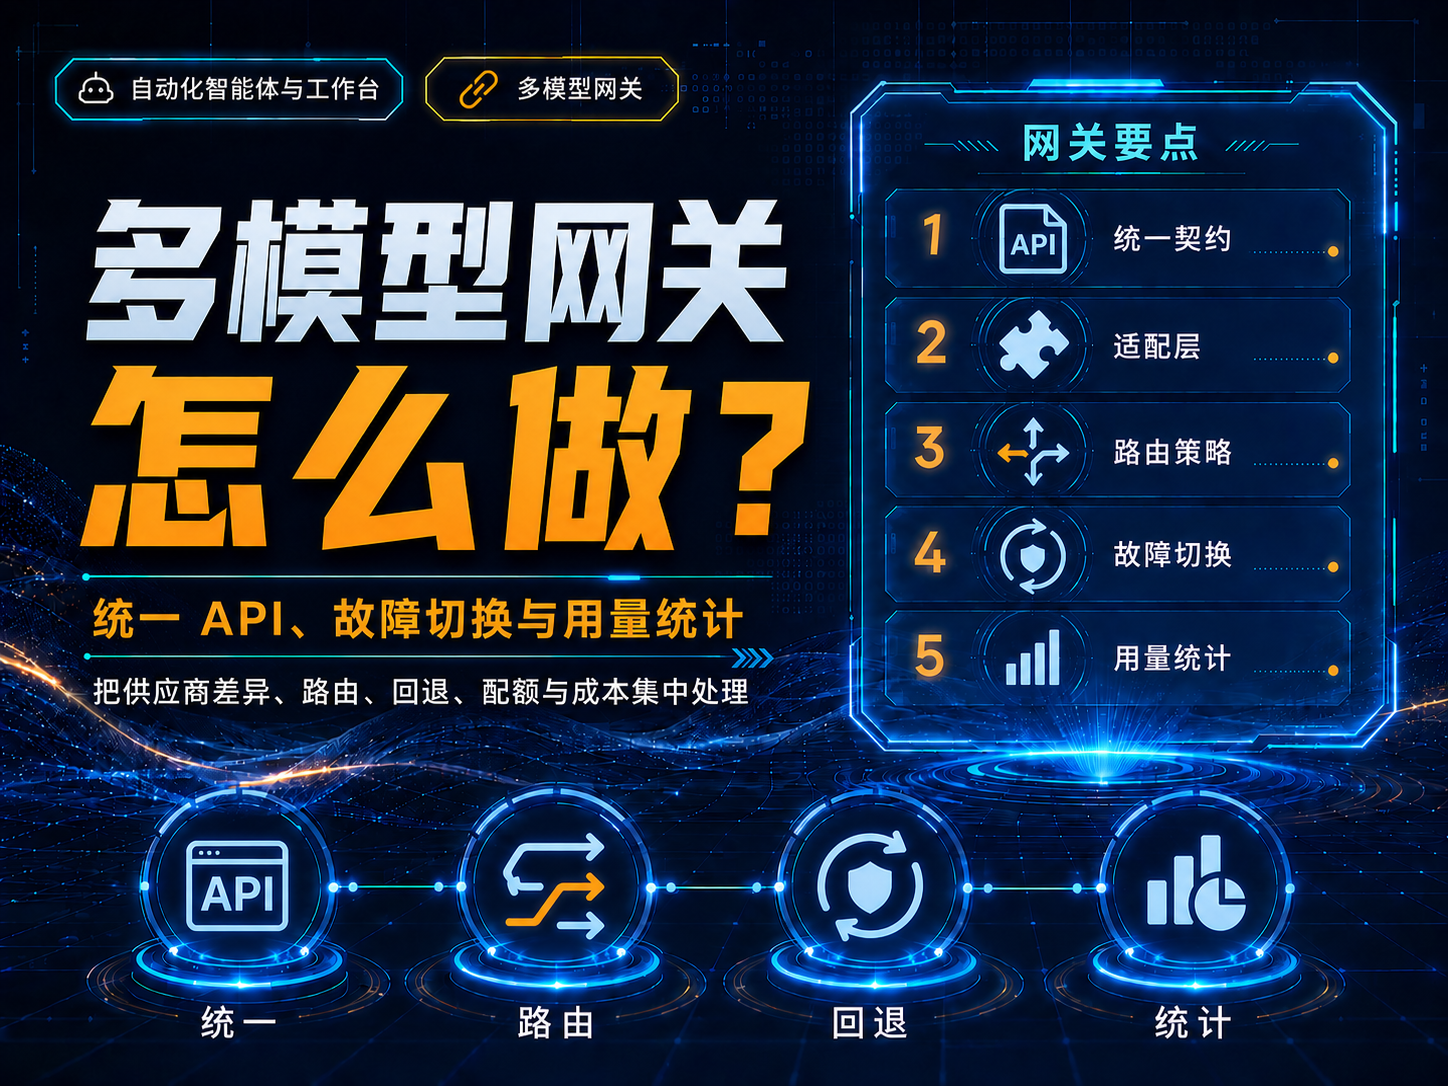
多模型网关怎么做?统一API、故障切换与用量统计
先定义内部模型别名
业务调用例如“fast-text”“reasoning-high”“vision-default”,网关再映射到具体供应商/模型。这样模型下线或价格变化时,不必修改所有业务代码。
统一契约只统一“公共部分”
消息、工具调用、结构化输出、错误等可以定义通用Schema;供应商特有能力通过显式extensions暴露,避免为了统一而丢失高级功能。
故障切换必须有条件
网络错误、限流、区域故障可以fallback;参数错误、权限错误、内容安全拒绝不应盲目切换供应商重试。回退前还要确认不同模型的工具/输出契约兼容。
网关记录每次调用的账本
- 内部request_id与业务项目。
- 实际provider/model。
- 输入输出Token、缓存、工具调用。
- 延迟、错误、重试、fallback链。
- 估算成本与预算标签。
先从单点代理开始
小团队可以先用一个代理服务统一Key和日志,再增加负载均衡、fallback、虚拟Key和预算。LiteLLM官方文档就是这种LLM Gateway模式的一个实现参考。
注意:不要在网关中悄悄把请求切到能力明显不同或数据政策不同的供应商;路由策略应可审计并符合用户/企业的数据约束。
资料核验日期:2026-08-09。产品功能、API、套餐、搜索规则与地区可用性会变化,正式使用前请再次查看官方页面。
参考来源
- LiteLLM:Getting Started / LLM Gateway(official/primary,核验于 2026-08-09)
- OpenAI Developers:Models(official/primary,核验于 2026-08-09)
更新记录
- 2026-08-09:完成官方/一手来源核验、结构化撰写与发布边界检查。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


 百度热点