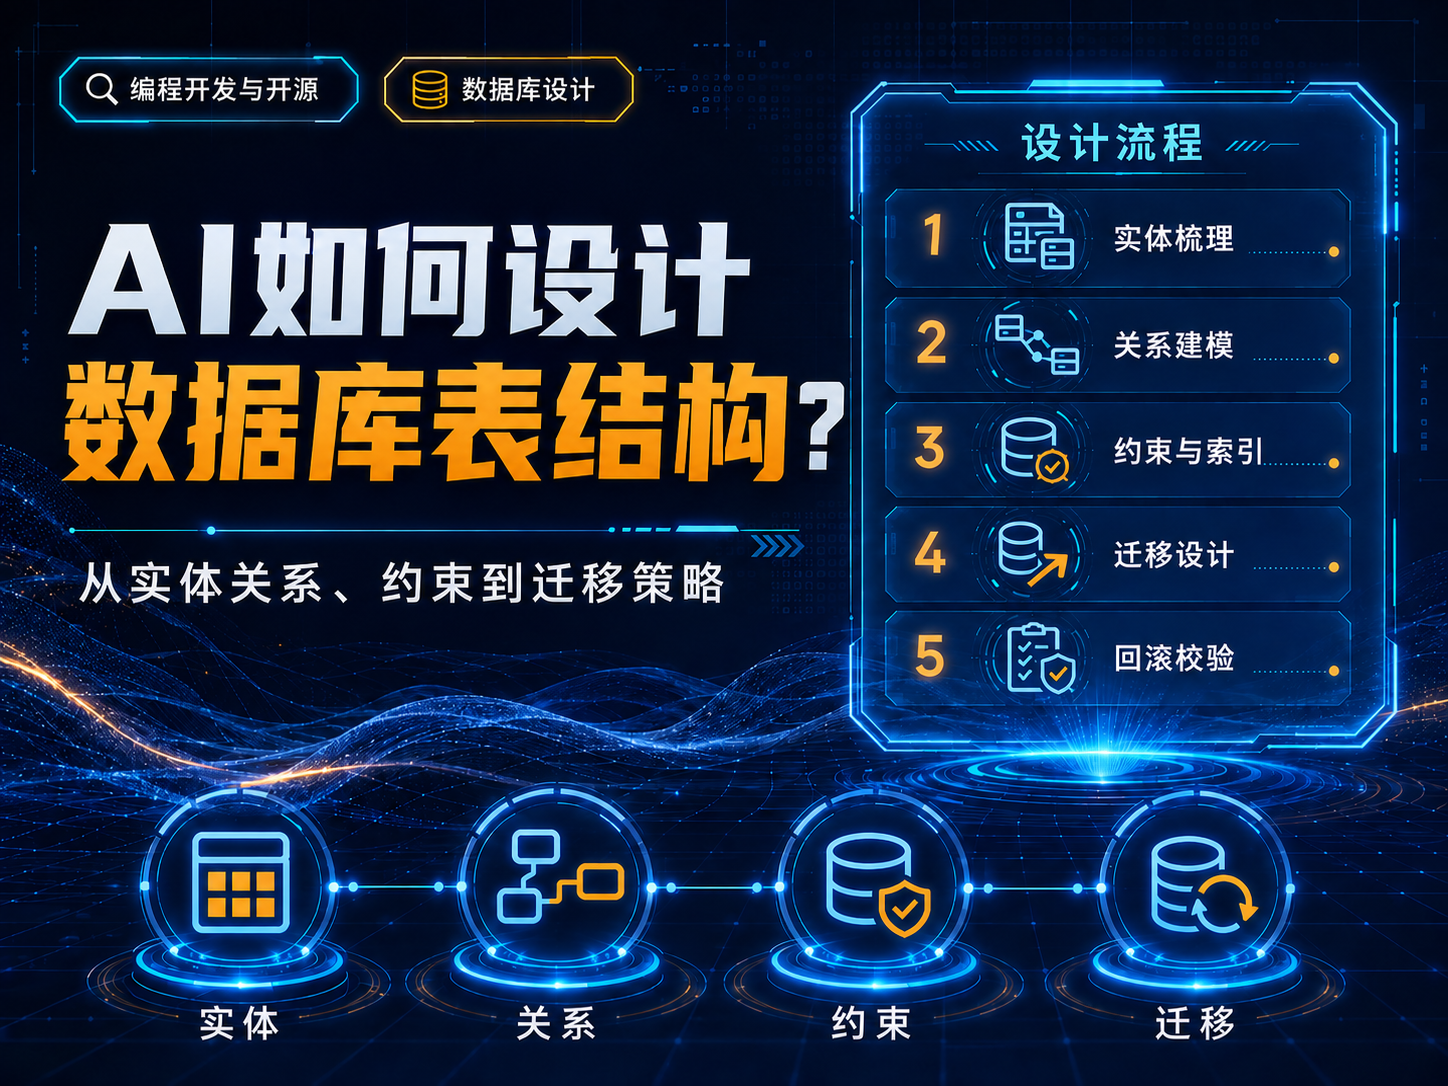
直接回答:AI最适合做数据库设计的结构化助手,不是替你决定业务模型。正确流程是“需求与样例 → 实体/关系 → 约束 → DDL草案 → 查询与索引验证 → 分阶段迁移 → 回滚预案”。数据库约束应尽量下沉到数据库层,生产变更则必须通过可审查的迁移记录执行。[1][2]
先从业务实体和事实规则开始,而不是先让AI画表
数据库设计的第一步应是列出业务实体、唯一身份、生命周期和它们之间的关系。AI可以帮助把需求描述转成候选实体和字段,但主键、唯一约束、外键和业务不变量必须由你确认。PostgreSQL把NOT NULL、UNIQUE、PRIMARY KEY、FOREIGN KEY和CHECK等约束作为数据定义的核心机制。[1]
一套可复用的AI设计流程
- 输入业务场景和5—10条真实样例。
- 让AI先输出实体、关系、关键状态和不变量,不写SQL。
- 确认后再生成ER图或DDL草案。
- 逐个字段检查类型、可空、默认值、唯一性、索引和外键。
- 用迁移脚本落地,而不是直接改生产表。
| 检查项 | 要问AI的问题 | 人工必须确认 |
|---|---|---|
| 实体 | 哪些对象有独立生命周期? | 是否真的需要独立表 |
| 关系 | 1:1、1:N还是N:N? | 删除/更新时的业务语义 |
| 约束 | 哪些值必须唯一或不可为空? | 业务不变量是否完整 |
| 索引 | 哪些过滤、排序、连接最频繁? | 真实查询与写入代价 |
| 迁移 | 旧数据如何兼容新结构? | 回滚、锁表和数据转换风险 |
不要把“索引建议”当成静态答案
AI可以依据查询形态提出索引候选,但索引会增加写入和存储成本,最终应结合真实查询计划、数据量和访问模式验证。不要因为字段常被搜索,就机械地给所有字段建索引。
迁移策略比最终表结构更重要
生产数据库变更要考虑旧版本应用是否仍在运行、字段回填是否耗时、DDL是否锁表、是否需要双写或分阶段切换。Prisma Migrate等迁移工具会保留迁移历史,并允许检查或修改生成的SQL,这正是“AI提方案、人审SQL、工具执行”的合适分工。[2]
可复制提示词
请先不要生成SQL。根据以下业务需求:
1. 列出实体、唯一身份、生命周期;
2. 列出实体关系和业务不变量;
3. 标出可能需要唯一约束/外键/CHECK的地方;
4. 给出3个最容易设计错的边界情况。
我确认后,再输出PostgreSQL DDL与分阶段迁移方案。
参考来源
- PostgreSQL Docs:Constraints(核验于 2026-08-08)
- Prisma Docs:Prisma Migrate(核验于 2026-08-08)
更新记录
- 2026-08-08:核验官方资料并完成全文结构化撰写。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


 百度热点