直接回答:Vibe Coding最大的问题不是“AI会不会写代码”,而是生成速度远快于理解、测试和治理速度。原型能跑只说明一条路径成立;要上线,还必须补齐安全、边界、数据迁移、监控、回滚与人工可维护性。
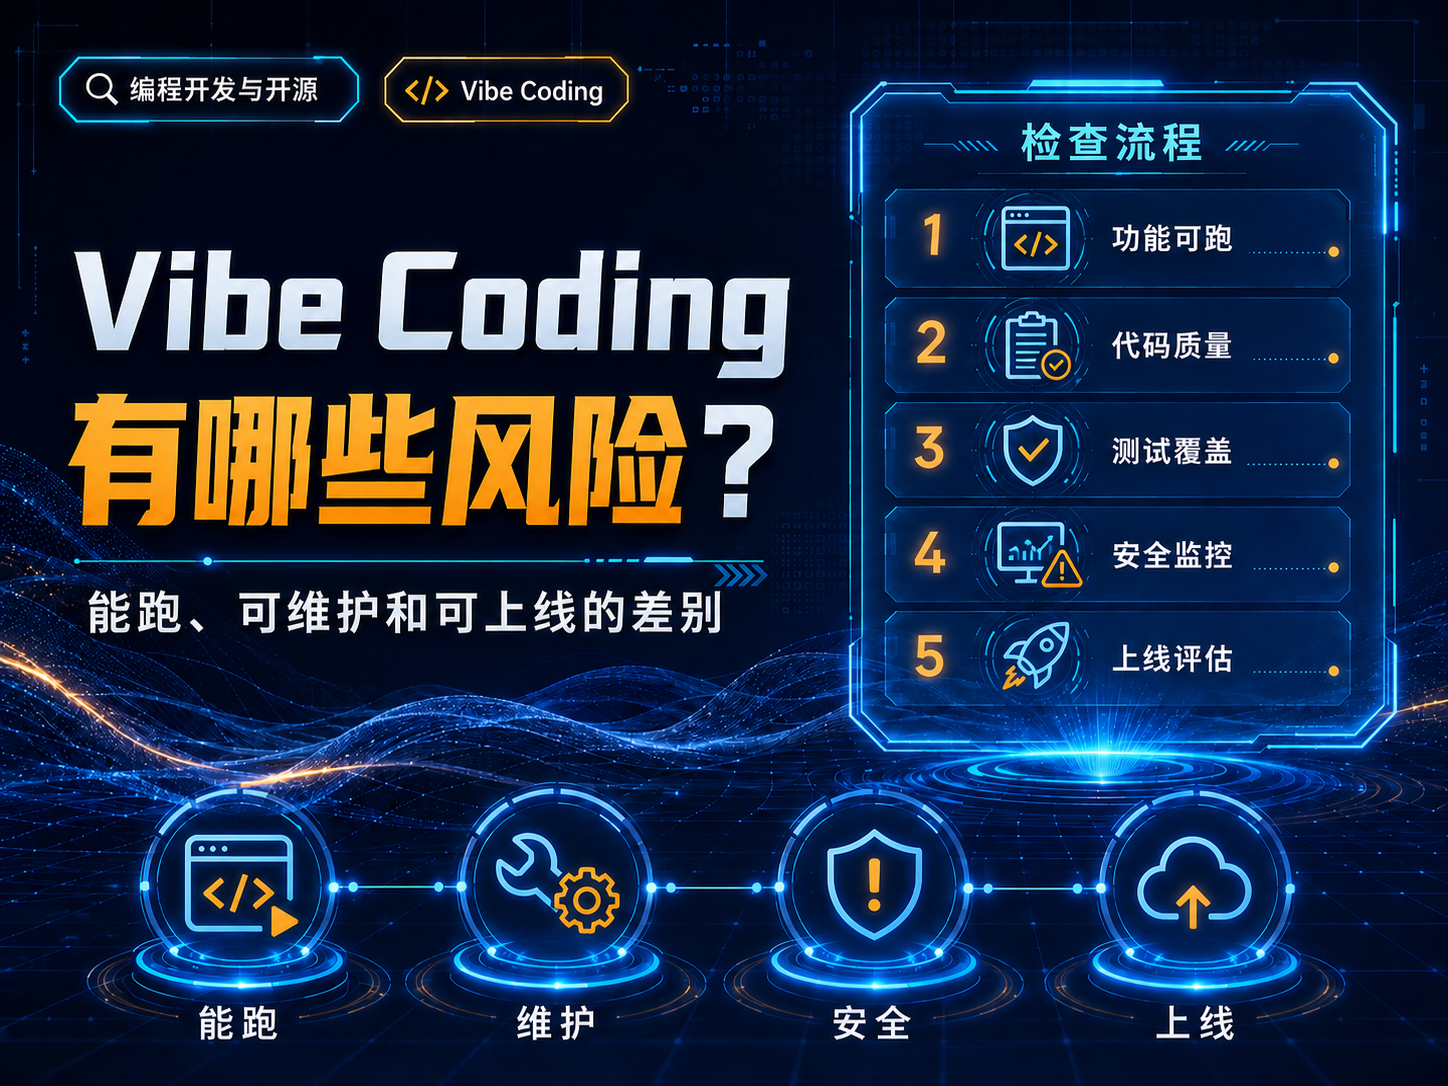
“能跑”只证明了最小路径,不证明产品质量
Vibe Coding常见问题是模型快速堆出功能,但隐藏了边界条件、权限、安全、数据迁移、错误恢复和长期维护成本。真正上线需要把隐式假设变成可验证的测试和规则。
| 层级 | 最低标准 | 仍然缺什么 |
|---|---|---|
| 能跑 | 主流程可执行 | 边界、异常、数据安全 |
| 可维护 | 结构清楚、测试可读、依赖受控 | 生产监控与运营 |
| 可上线 | 安全、性能、迁移、回滚、监控完成 | 持续维护与响应机制 |
最危险的是“看不懂但敢改”
如果开发者无法解释认证、数据模型、支付、权限或部署代码,就不应该把这部分直接推到生产。AI可以生成实现,但责任仍在提交和发布代码的人。
上线前五道门
- 关键业务行为有自动测试。
- 依赖、密钥和权限经过安全检查。
- 数据库变更有迁移和回滚路径。
- 生产部署受保护并有监控。
- 核心模块至少有一名人类能解释和维护。
安全和业务逻辑不能只靠扫描器
OWASP指出手工安全代码审查仍能发现自动工具难以识别的业务逻辑和上下文问题。Vibe Coding越依赖大规模自动生成,越应该把人工Review集中到身份、授权、资金、数据和外部调用等高风险区域。[1]
把AI从“作者”变成“受约束的执行者”
先写验收标准和测试,让AI在这些约束里实现;每次只做小改动,保留清晰diff;未知部分先解释再修改。这样效率仍然高,但错误更容易被发现和回滚。
参考来源
- OWASP:Secure Code Review Cheat Sheet(核验于 2026-08-08)
- GitHub Docs:Deployments and environments(核验于 2026-08-08)
更新记录
- 2026-08-08:核验官方资料并完成全文结构化撰写。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


 百度热点